1. はじめに
 (拡大画像を開く)
近年のAI技術の発展に伴い、機械学習がさまざまな分野に導入され、製造業における品質予測や医療・生命科学分野におけるデータの分析など、その活用の場面は多岐にわたります。
例えば化学物質の性質を予測するAIを開発する際、予測精度を高めるにはできるだけ多くのデータを集めることが理想です。しかし、実際に実験データを収集するには、時間も費用もかかります。必要なデータが分からないまま収集を続けるのは、効率的ではありません。
では具体的にどの程度準備できればよいのでしょうか?
1000件あればよいのでしょうか。1万件、100万件、それともそれ以上でしょうか。
実は、この点に関して、すべての課題に共通する正解はありません。必要なデータ量は、予測したい対象やデータの質、目標とする精度などによっても変化します。
それでは、データを大量に収集する前に、必要な量をある程度見積もることはできないのでしょうか?
この記事では、手元にあるデータを用いて小規模な学習を行い、データ量と予測性能の関係から、追加のデータによって予測性能がどの程度改善するのかを大まかに見積もる手法について扱います。
そして、実際に化学分野の公開データセットを用いて、必要なデータ量を見極める方法について検証していきます。
2. 学習曲線で必要なデータ量を予測する
2.1 必要なデータ量に明確な基準はない
AIモデルの学習に必要なデータ量は、扱う課題やデータの性質、求める予測精度などによって異なるため、単純にデータを増やせば、それに比例して予測精度が向上するわけではありません。例えば、ある課題では数百件のデータで十分な予測性能が得られる一方で、別の課題では数千件のデータを使用しても期待する性能に達しない可能性があります。
重要なのは、どれだけのデータを使用すれば、目標とする予測性能に到達できるかということです。その大まかなデータ数を見積もるため、まず手元にあるデータから小規模な学習を行い、目標とする精度に必要なデータ量を逆算してみつもるという方法があることはお伝えしました。
その具体的な手法の一つに、「学習曲線」という手法があります。
2.2 学習曲線とは?
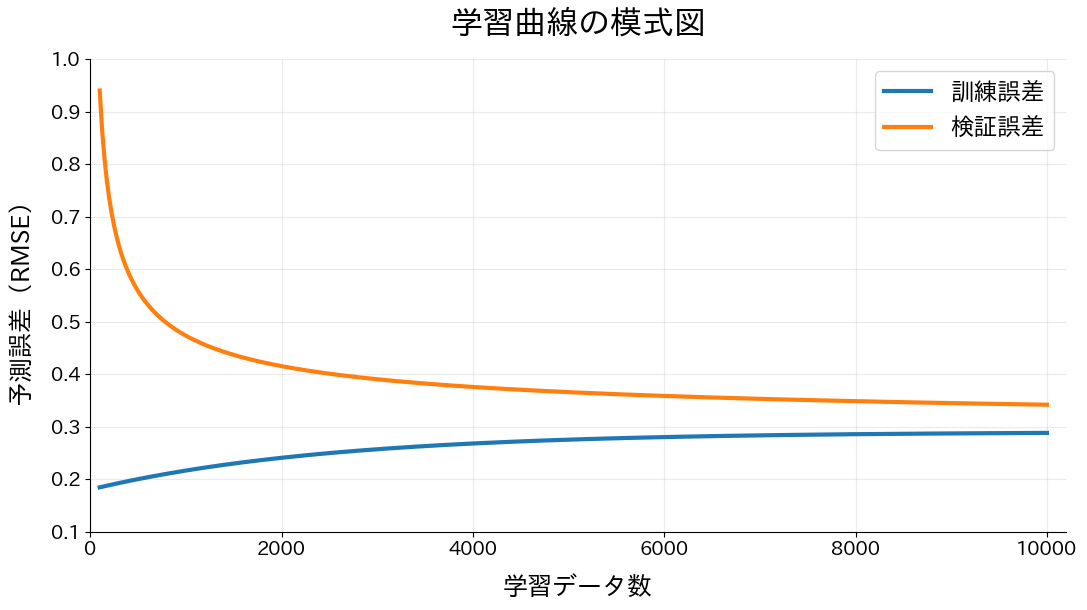
学習曲線とは、学習に使用するデータの数を変化させることにより、AIモデルの予測性能がどのように変化するのかをグラフで表したものです[1] 。
(拡大画像を開く)
100件、200件とデータ数を段階的に増加させながらモデルを学習させ、それぞれの予測誤差を測定します。
一般的に、データ数が増えることにより予測誤差が小さくなり、次第に改善幅が緩やかになる傾向があります。ただし、実際の変化はデータの質や扱うモデルによっても当然異なります。
2.3 学習曲線から将来の予測精度を見積もる
では、この学習曲線を用いて、まだ学習に使用していないデータ量での予測精度を見積もることはできるのでしょうか?
その方法の一つが、学習曲線の外挿です。
外挿とは、すでに得られているデータの傾向から、まだ観測していない範囲の値を推定することです。
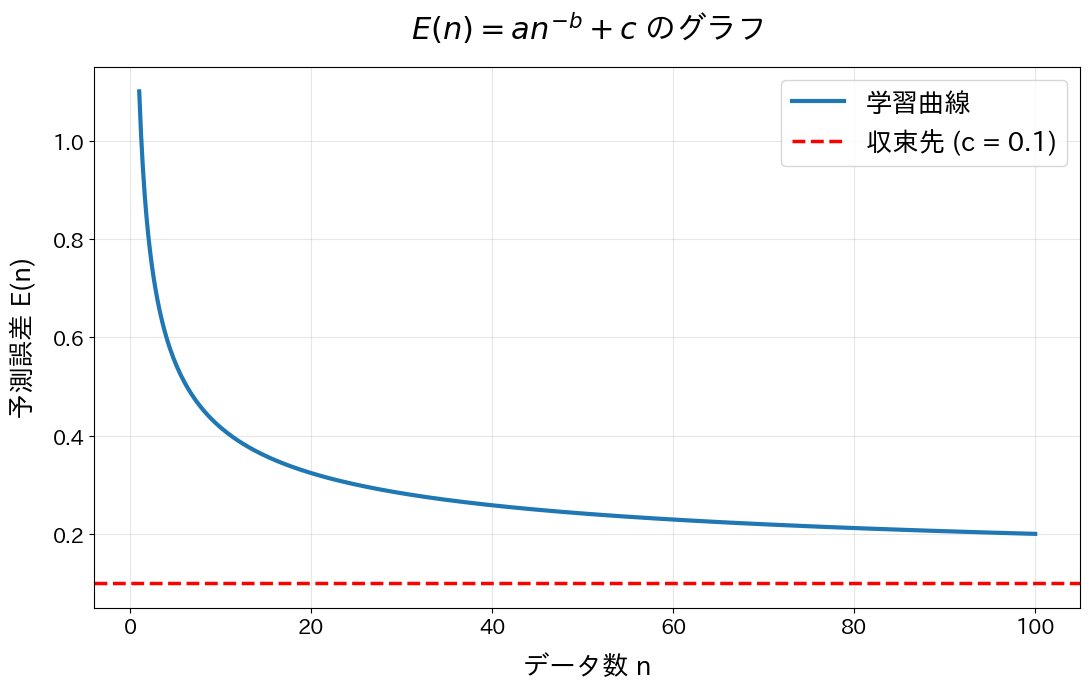
今回の実験では学習データ数と予測誤差の関係を次の式で近似します[1] 。
E(n) = an−b + c
 (拡大画像を開く)
この式は、データ数が増えるにつれて、予測誤差の改善が緩やかになっていく関係を表現できます。
ただし、実際の学習曲線は必ずしもこの式に従っているわけではありません。特に、実際に学習した範囲から大きく離れたデータ量を予測する場合、推定結果が不正確になる可能性があります。
したがって、学習曲線による外挿は、結果を保証するものというよりは、あくまで大まかに必要なデータ量を推定する方法のうちの一つです。
3. 実際のデータで検証してみる
3.1 今回使用するデータセット
今回の実験では、化学分野の機械学習で幅広く使用されている「MoleculeNet」[2] から、公開されている2種類のデータセットを使用しました。
「MoleculeNet」とは、分子構造から化学的性質などを予測する機械学習モデルの性能を評価するために整備されたデータセット群です。
このデータセット群の中から、以下の二つを主に使用します。
| データセット | ESOL | Lipophilicity |
|---|---|---|
| データ数 | 1,128件 | 4,200件 |
| 予測対象 | 水溶解度 | 脂溶性に関する指標 |
| 入力データ | 分子構造 | 分子構造 |
| 問題の種類 | 回帰予測 | 回帰予測 |
ESOLは、化学物質が水にどの程度溶けるのかを示す「水溶解度」を予測するためのデータセットです。[3]
一方Lipophilicityは、化学物質の水と油への分配されやすさを示す指標を予測するためのデータセットです。[4]
いずれも、分子構造から水溶解度や脂溶性といった物性値を予測する問題です。このように、数値を予測する機械学習の課題を「回帰問題」と呼びます。
今回は、この2つのデータセットを使用することで、予測する課題の内容によって学習データ量と予測精度がどのように変化するのかを検証します。
3.2 実験方法
今回の実験では、Pythonを使用し、Google ColaboratoryのNotebook上で機械学習モデルを構築しました。
まず、RDKitという化学情報処理ライブラリを使用して分子構造を表す文字列データを数値化します。
その後、Random Forestと呼ばれる、複数の決定木を組み合わせることで予測を行う手法を用いて、分子の化学的性質を予測します。
(Random Forestに関してはこちらの記事で詳しく説明しております)
今回の目的は、モデル自体の性能を最大化することではなく、学習データ量を変化させることで、予測精度がどのように変化するかを調べることです。
そのため、モデルの設定は固定し、学習に使用するデータ数を段階的に増加させることで実験を行いました。
実験は、次の3段階で行います。
① 学習データ数を変えてモデルを学習する
学習データ数を段階的に増やし、それぞれのデータ量における予測誤差を測定します。
② 少量データから将来の予測精度を推定する
得られた学習曲線を先ほどの数式で近似し、さらにデータ数を増やした場合の予測誤差を見積もります。
③ 実際に学習させて答え合わせをする
推定した件数のデータを使って実際にモデルを学習し、見積もった予測誤差と比較します。
予測性能の評価にはRMSE(二乗平均平方根誤差)を使用しました。この評価方法は、モデルの予測値と実際の値がどの程度ずれているのかを示す指標で、この値が小さいほど予測誤差が小さいことを意味しています。
なお、今回の実験では、学習用と評価用のデータを分け、各データ量について、3回ずつ学習を行います。
4. 実験結果 -予測はどこまで正確なのか?-
4.1 学習データの増加と予測精度の変化
まず、2つのデータセットについて、学習データを増やした際の予測誤差の変化を確認します。
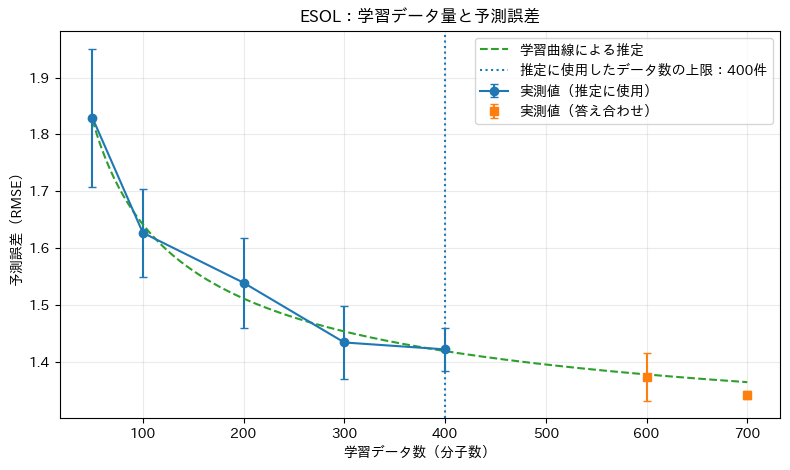
ESOL(水溶解度)の場合
 (拡大画像を開く)
※エラーバーは、各データ数における3回の試行結果の標準偏差を表しています。
ESOLでは、学習データ数を50件から400件に増やした結果、RMSEが1.829から1.422へと減少しました。これは、予測誤差が約22%減少したことを示しています。
特に、50件から100件に増やした段階では比較的大きな改善が見られました。一方300件から400件に増やした際の改善幅は小さくなっています。
このように、データ数の増加によって予測精度が改善する一方、その改善幅は一定ではないことが、上のグラフからも視覚的に確認することができます。
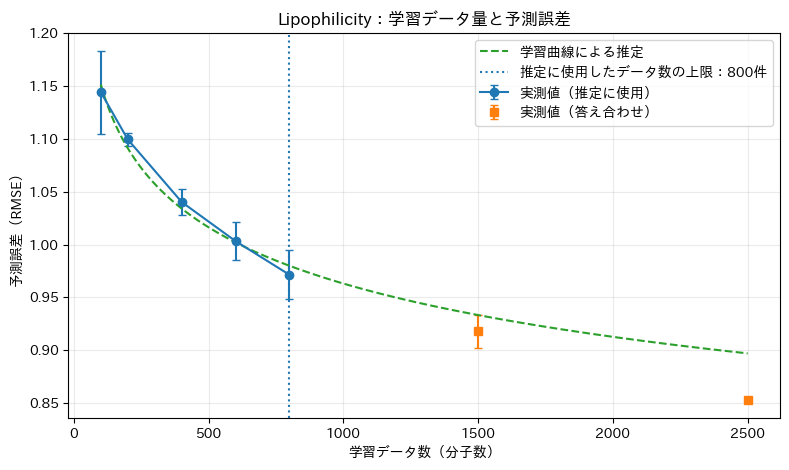
Lipophilicity(脂溶性)の場合
 (拡大画像を開く)
※エラーバーは、各データ数における3回の試行結果の標準偏差を表しています。
Lipophilicityについても、学習データ数を100件から800件に増やした結果、RMSEが1.144から0.971へと減少しました。
こちらもデータ数の増加に伴って予測誤差が減少していますが、その変化の仕方はESOLとは異なっています。
今回の実験では、どちらのデータセットでも、学習データ量の増加による予測性能の改善が確認できましたが、その改善傾向には違いが見られました。
ただし、2つのデータセットは予測対象や測定値の性質が異なります。そのため、RMSEの大きさだけを比較して、どちらの課題が難しいかを判断することはできません。
4.2 少量データからの見積もりはどれくらい当たるのか?
続いて、少量データで得られた学習曲線から、さらにデータ数を増やした場合の予測誤差を推定しました。
ESOLでは400件まで、Lipophilicityでは800件までの学習結果を使用して曲線を近似し、それぞれのデータ量を超えた場合の予測誤差を見積もりました。
その後、実際により多くのデータで学習させることにより、推定結果と比較しました。
結果は以下のとおりです。
| データセット | 学習データ数 | 推定RMSE | 実測RMSE | 見積もりの相対誤差 |
|---|---|---|---|---|
| ESOL | 600件 | 1.378 | 1.374 | 0.33% |
| ESOL | 700件 | 1.365 | 1.342 | 1.66% |
| Lipophilicity | 1,500件 | 0.933 | 0.918 | 1.68% |
| Lipophilicity | 2,500件 | 0.897 | 0.853 | 5.15% |
※相対誤差は、推定RMSEと実測RMSEの差を、実測RMSEに対する割合で表したものです。
ESOLでは、600件・700件における推定値と実測値の相対誤差は、それぞれ約0.3%、1.7%となりました。一方、Lipophilicityでは、1,500件での相対誤差が約1.7%、2,500件では約5.1%となりました。
今回の実験では、少量のデータから学習曲線を用いることで、データ量を増やした場合の予測誤差を、ある程度近い値で見積もることができました。
この結果は、実際のAI開発においても重要な意味を持ちます。
例えば今回のように化学物質の性質を予測するAIを開発する場合、学習データとなる実験結果を新たに収集するためには、時間や費用が追加でかかる場合があります。
そのような場合、最初から大量のデータを収集するのではなく、まず手元のデータを用いて学習曲線を作成することで、追加データの収集によって、どの程度の性能改善が期待できるのかを検討するための判断材料が得られます。
一方で、今回のLipophilicityの実験では、2,500件における推定値と実測値の差が、1,500件の場合よりも大きくなりました。
このように、学習曲線による見積もりは必ずしも正確ではなく、特に実際に学習した範囲から離れたデータ量を推定する際には注意が必要です。
したがって、学習曲線による予測は、必要なデータ量を確定するためのものではなく、追加データを収集するべきか、どの程度の規模で収集するべきかを考えるための目安として活用することが重要です。
4.3 結局、どれくらいのデータが必要なのか?
ここまでの実験から、学習曲線を利用することで、データを追加した場合の予測性能を大まかに見積もれることが確認できました。
しかし、そもそも「何件のデータがあれば十分なのか」を判断するためには、もう一つ重要な要素があります。
それが、目標とする予測精度です。
例えば、ESOLにおいて、RMSEを1.4以下にすることを目標とした場合を考えます。
今回の実験では、400件までの学習結果から近似した学習曲線を使い、目標のRMSEを達成するために必要なデータ量を逆算することができます。
実際に計算すると、RMSEが1.4となる学習データ数は約480件と推定されました。
では、この見積もりは実際の学習結果と一致するのでしょうか。
今回の実験では、400件で学習した場合のRMSEは1.422であり、目標には達していませんでした。一方、600件ではRMSEが1.374となり、目標を下回りました。
したがって、今回の条件では、400件では目標に達しなかったものの、600件では達成できたことが確認できます。
ただし、約480件という数字は学習曲線から算出した推定値であり、実際に480件で学習して目標を達成できることを確認したわけではありません。
また、今回設定したRMSE 1.4という目標は説明のための仮の値であり、実際の業務で十分な精度かどうかは、利用目的によって異なります。
このように、必要なデータ量を見積もるためには、まず目標とする予測精度を定め、その目標に対して学習曲線を活用することが重要です。
そして、見積もったデータ量を絶対的な基準とするのではなく、追加の学習と評価を繰り返しながら、その妥当性を確かめていく必要があります。
5. 結論 -AI開発をどう始めるか?-
本記事では、AIモデルの学習に必要なデータ量について、学習曲線を用いた見積もり方法を紹介し、実際の化学データを使用して検証しました。
今回の実験では、少量のデータから得られた学習結果をもとに、データを追加した場合の予測性能をある程度見積もることができました。一方で、こうした見積もりが必ずしも正確とは限らず、扱うデータや予測対象によって結果が異なることも確認できました。
では、実際にAI開発を進める際には、どのように必要なデータ量を判断すればよいのでしょうか。
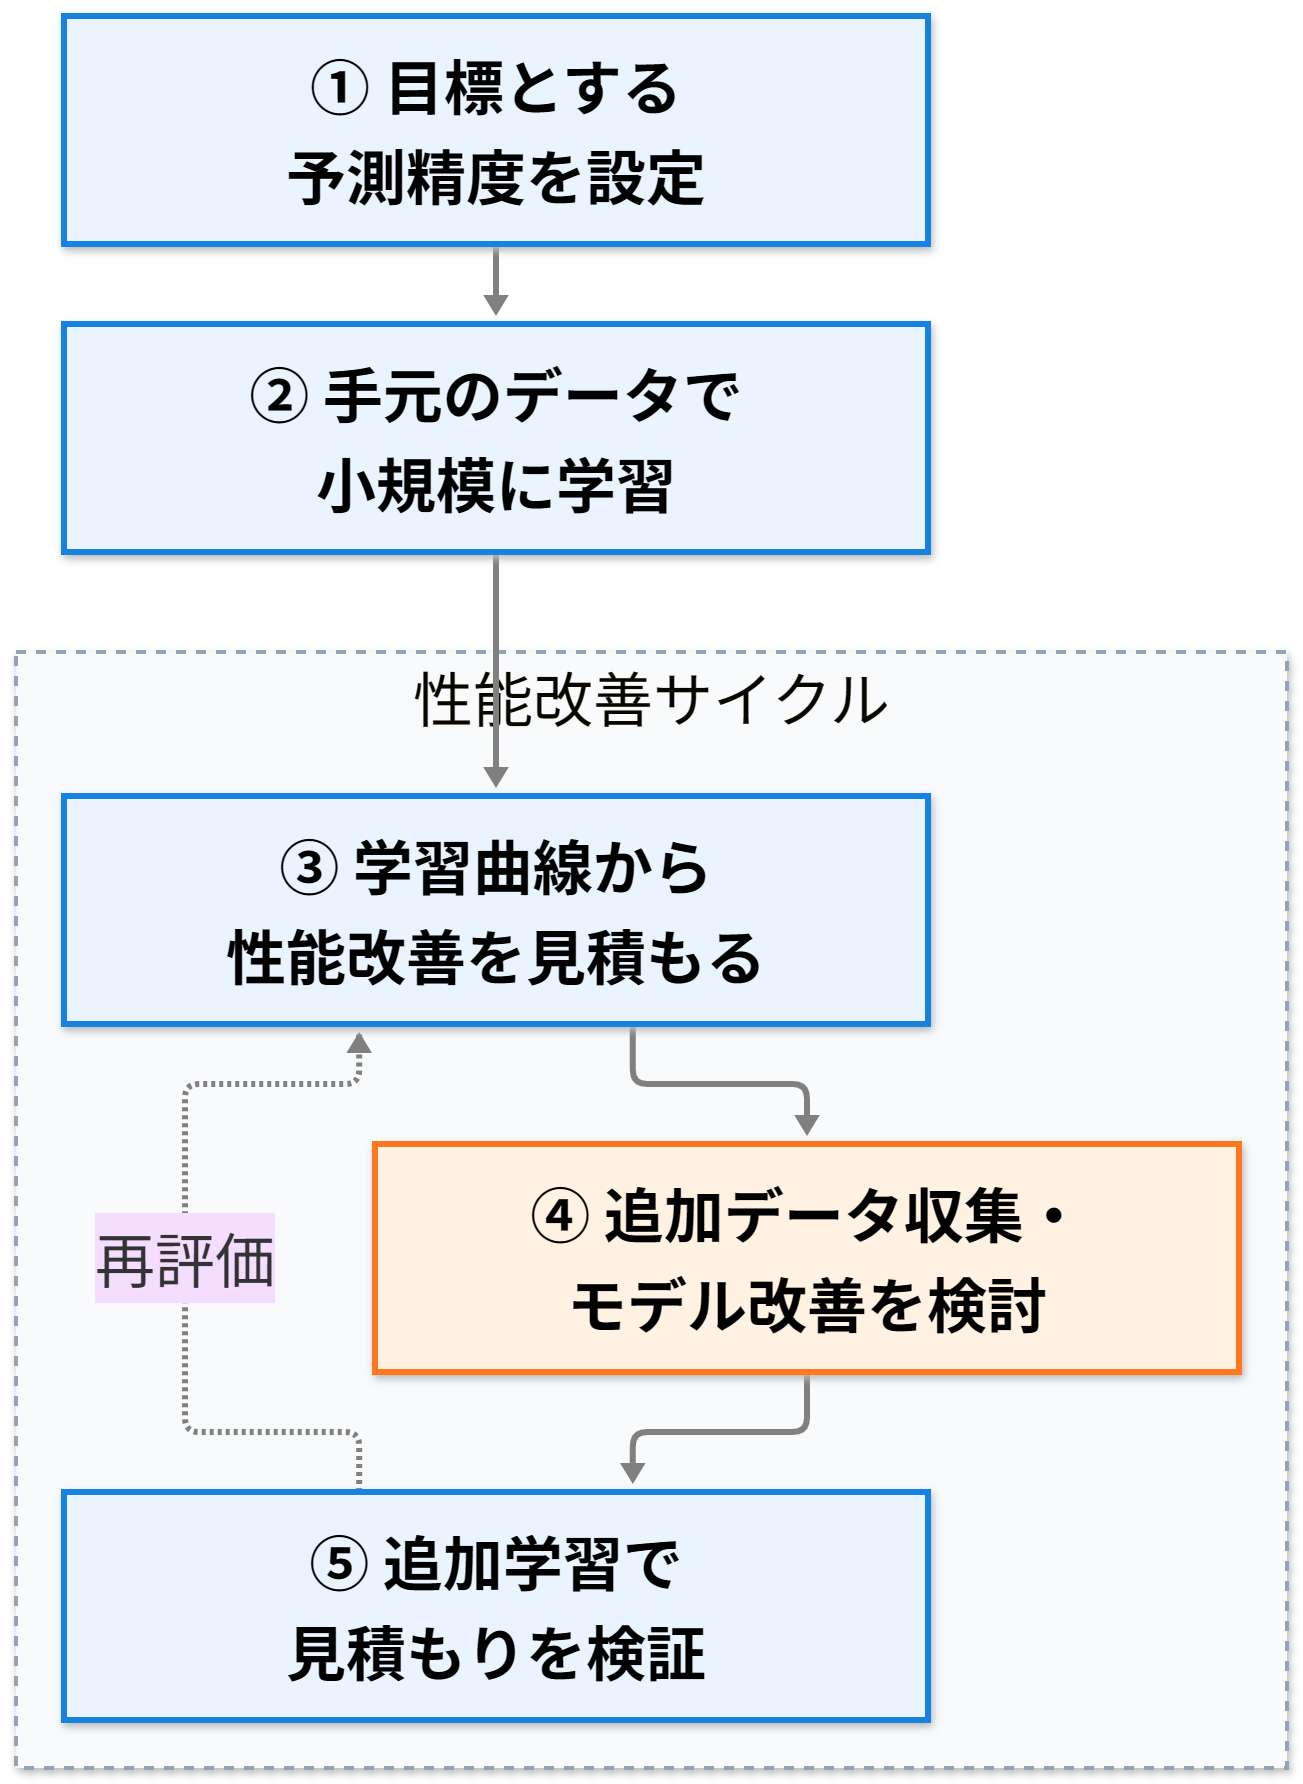
重要なのは、最初から必要なデータ量を正確に決めようとするのではなく、まず手元のデータで小規模な検証を行い、その結果をもとに次の方針を判断することです。
 (拡大画像を開く)
具体的には、目標とする予測精度を設定したうえで、手元のデータを使ってモデルを学習させ、学習曲線から追加データによる性能改善を見積もります。そして、その結果を参考に、データの追加収集やモデルの改善を検討していきます。
IDATENaseでも、AIモデルの開発をご提案する際には、まず小規模なデータによる検証を実施し、その結果を踏まえて本格的な開発を検討する場合があります。
AI開発に必要なデータ量を事前に正確に把握することは困難ですが、実際に小規模な学習を行うことで、その判断に必要な情報を得ることは可能です。
まずは手元のデータから検証を始め、その結果に応じて段階的に開発を進めることが、AI導入を検討するうえで有効なアプローチの一つといえるでしょう。
参考文献
[1] Viering, T., & Loog, M. (2023). The Shape of Learning Curves: A Review. IEEE Transactions on Pattern Analysis and Machine Intelligence, 45(6), 7799–7819. https://doi.org/10.1109/TPAMI.2022.3220744
[2] Wu, Z., et al. (2018). MoleculeNet: A Benchmark for Molecular Machine Learning. Chemical Science, 9, 513–530. https://doi.org/10.1039/C7SC02664A
[3] Delaney, J. S. (2004). ESOL: Estimating Aqueous Solubility Directly from Molecular Structure. Journal of Chemical Information and Computer Sciences, 44(3), 1000–1005. https://doi.org/10.1021/ci034243x
[4] Hersey, A. (2015). ChEMBL Deposited Data Set – AZ Dataset. ChEMBL. https://doi.org/10.6019/chembl3301361
使用したデータセット
以下のリポジトリにおいて配布されているESOL,Lipophilicityを使用した
https://github.com/deepchem/deepchem (閲覧日:2026年11月8日)