1. はじめに
材料開発における課題と聞いて、皆さんは何を思い浮かべるでしょうか?
材料開発には、性能の向上や製造コストの削減など、さまざまな課題が存在します。
その中でも、新しい材料を探索する際に大きな障壁となるのが、材料候補の膨大さと、それらを評価するために必要な時間とコストです。
材料の性質は、使用する元素の種類や組成比、結晶構造、製造条件などによって大きく変化します。そのため、考えられるすべての組み合わせを実験によって一つひとつ検証することは、現実的ではありません。
こうした課題に対するアプローチの一つとして、注目されているのがマテリアルズ・インフォマティクス(Materials Informatics:MI)です。
本記事では、マテリアルズ・インフォマティクスの基本的な考え方を紹介するとともに、機械学習の一手法であるランダムフォレストを例に、新材料探索への活用方法を解説します。
さらに、実際の研究事例を通して、その可能性と課題について考えていきます。
2. マテリアルズ・インフォマティクスとは?
マテリアルズ・インフォマティクス(Materials Informatics:MI)とは、材料科学とデータ科学を組み合わせ、材料の研究開発を効率化するアプローチです。
材料開発では、従来から研究者の知識や経験、理論計算、実験などによる試行錯誤が重要な役割を果たしてきました。
一方、MIでは、これらに加えて過去の実験結果やシミュレーションなどから得られたデータを統計解析や機械学習などによって分析し、新たな材料の候補を探索することが可能になります。
これにより、実験を行う前に有望な材料候補を絞り込み、どの候補を優先的に実験で検証するかを判断しやすくなります。
例えば、求める性能を持つ材料を開発する場合、過去の実験データなどをもとに、まだ試していない材料の性質を予測し、その結果を参考に実験の優先順位を決めることができます。
さらに、実験から得られた新しいデータを次の分析に活用することで、材料探索を継続的に改善することができます。
このようにMIを活用することで、研究者の経験や実験を活かしながら、限られた研究時間や設備を効率的に利用し、材料開発に必要な時間やコストの削減につなげることが期待されています。
2.1 MIではどのようなデータを扱うのか?
MIで扱うデータは多岐にわたります。例えば、材料を構成する元素の種類や組成比、原子の配列を表す結晶構造、製造時の温度や圧力などの製造条件、さらには電気伝導率などの物性データが挙げられます。
これらのデータは、実験やコンピュータによるシミュレーション、研究論文、材料データベースなどから得られます。一部のデータは公開されていますが、材料や測定条件によっては必要なデータを十分に入手できない場合もあります。
このように多様なデータが用いられるのは、材料の性質がさまざまな要因によって変化するためです。
例えば、同じ組成の材料であっても、製造条件や内部の微細構造が異なれば、強度や電気抵抗率などの物性が変化する場合があります。
そのため、MIでは予測したい物性に応じて、材料の組成だけでなく、構造や製造条件などの情報も考慮することが重要になります。
2.2 機械学習は材料探索にどう役立つのか?
MIで活用される代表的な技術の一つが機械学習(Machine Learning:ML)です。
機械学習では、コンピュータがデータに含まれる傾向や規則性を学習し、未知のデータに対する予測や分類を行います。また、大量のデータを解析することで、人間が気づきにくい特徴や複雑な関係性を見出すことにも活用されています。
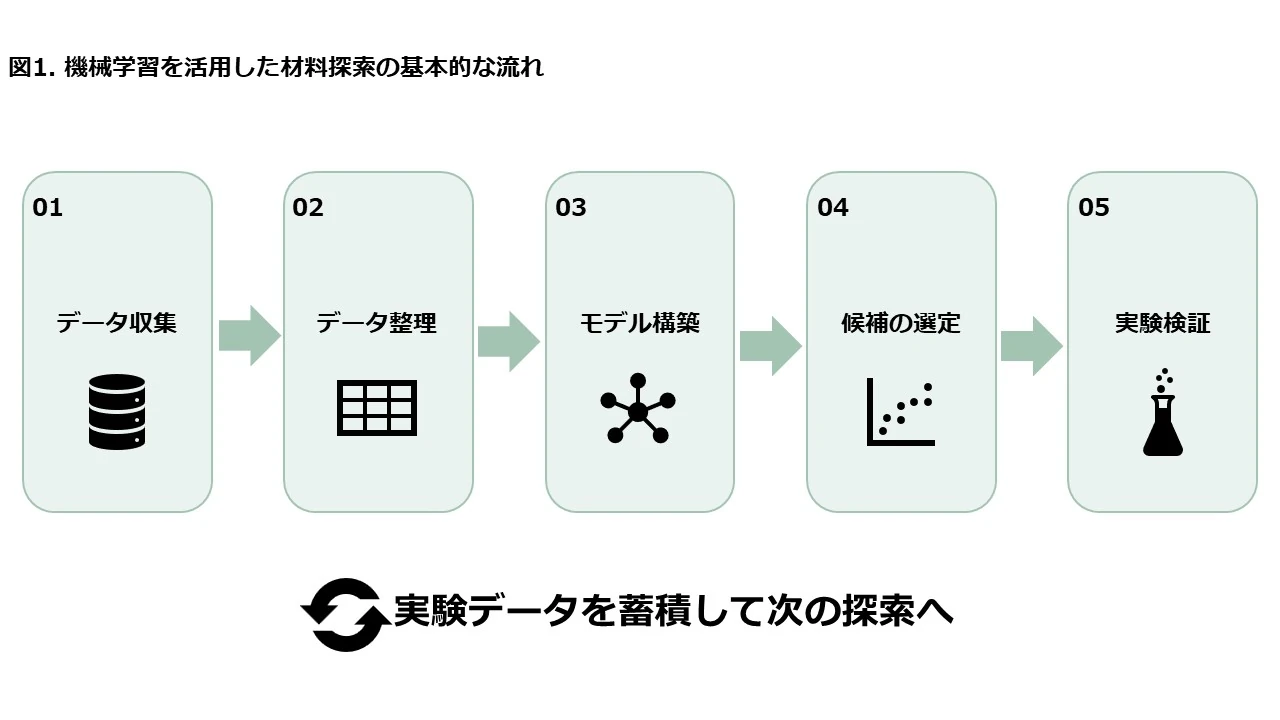
図1に機械学習を用いた新規材料探索の一例を示します。
 (拡大画像を開く)
まず、実験やシミュレーション、材料データベースなどから、既存の材料データを収集します。次に、収集したデータを整理し、材料の組成や構造などの情報を機械学習で扱える形に変換します。
これらのデータの一部を用いて機械学習モデルを構築し、材料に関する情報と、その性質や結晶構造などとの関係を学習させます。その後、実験結果がすでに分かっているものの、学習には使用していないデータを用いて、モデルの予測結果と実際の結果を比較します。これは、学習したデータ以外に対しても、どの程度正確に予測できるかを確かめるための工程です。
その後、予測性能を確認したモデルを用いて、まだ実験していない材料候補の物性や、特定の結晶構造を形成する可能性などを予測します。この工程では、モデルの性能を評価するのではなく、実際に実験で検証する価値のある材料候補を探します。
得られた予測結果をもとに、研究目的に合った有望な材料候補を選定し、優先的に実験を行うことで、材料探索の効率化が期待されます。
最後に、選定した材料を実際に作製・評価し、予測結果を検証します。さらに、実験によって得られた新たなデータを蓄積し、モデルの改善や次の材料探索につなげることも可能になります。
このように、機械学習による予測と実験による検証を繰り返すことが、データを活用した材料探索の基本的な考え方です。ただし、予測の信頼性は学習データの量や品質などによって左右されるため、材料科学の知識に基づいた評価も重要になります。
3. ランダムフォレストによる新材料探索
本章では、機械学習の一手法であるランダムフォレストを取り上げ、実際の新材料探索への応用事例を紹介します。
その研究内容を理解するために、まずランダムフォレストの基本的な仕組みを説明し、続いて、Oliynykら(2016)の研究をもとに、新材料の候補探索から実験による検証までの流れを解説します。
3.1 ランダムフォレストとは?
ランダムフォレスト(Random Forest:RF)は、複数の決定木を組み合わせて予測を行う機械学習の手法です。
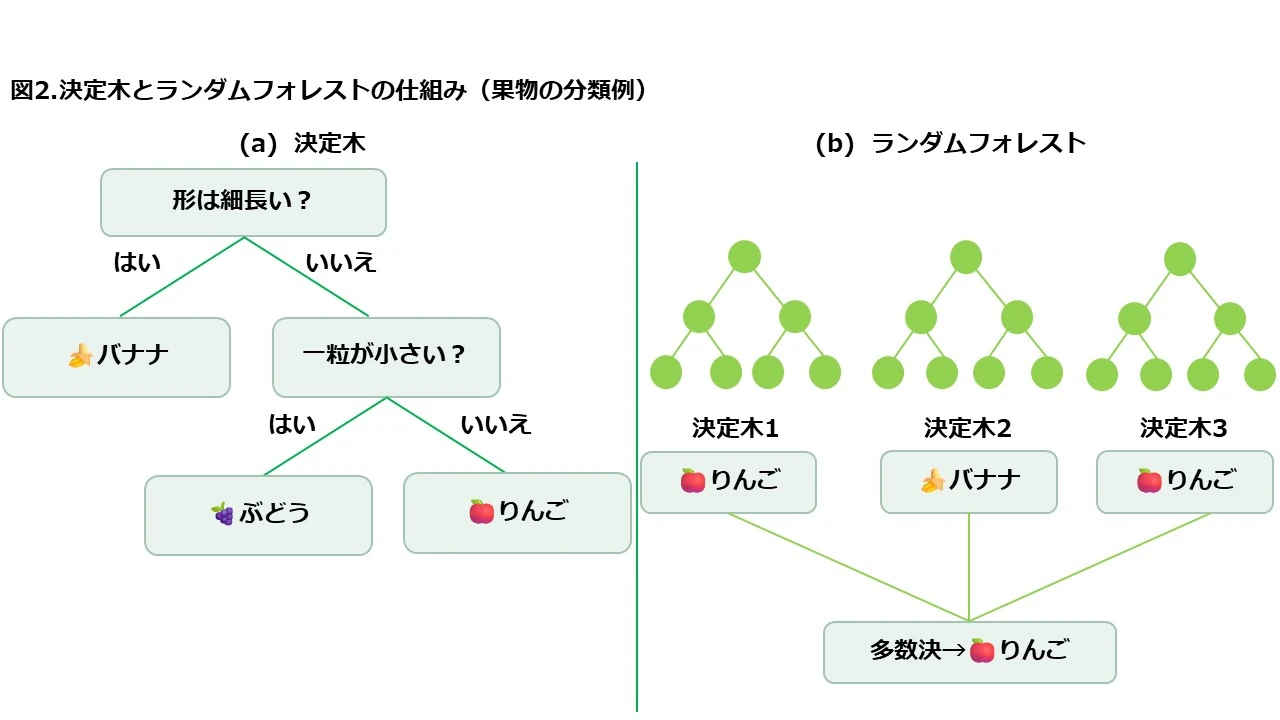
決定木では、データに含まれる特徴をもとに条件分岐を繰り返し、予測や分類を行います。例えば、果物を見分ける場合、「形は細長いか?」、「一粒が小さいか?」といった条件を順番に確認することで、果物の種類を分類できます。
ただし、1本の決定木だけでは、学習に使用したデータの細かな特徴に影響されやすく、未知のデータに対して十分な予測性能が得られない場合があります。
そこで、ランダムフォレストでは、複数の決定木を組み合わせることで、この弱点を補います。具体的には、学習に使用するデータや条件分岐に用いる特徴をランダムに選びながら複数の決定木を構築し、それぞれの予測結果を統合します。分類を行う場合には、各決定木の結果を多数決などによってまとめ、最終的な予測を決定します。
このように、複数のモデルによる予測を組み合わせる方法は「アンサンブル学習」と呼ばれます。
1本の決定木だけに頼らず、複数の判断を組み合わせることで、予測のばらつきを抑え、より安定した予測が期待できます。
図2に、身近な果物の分類を例として、決定木とランダムフォレストの仕組みを示します。
 (拡大画像を開く)
実際の材料探索では、果物の形や大きさの代わりに、原子半径や電気陰性度などの元素の性質を特徴として用い、材料の分類や予測を行います。
次節では、ランダムフォレストを新しい材料の探索に活用した研究事例を紹介します。
3.2 研究事例:ホイスラー化合物の探索
前節で紹介したランダムフォレストは、新材料探索にも活用されています。
実際に、Oliynykらは、ランダムフォレストを用いて、新しいホイスラー化合物を探索する研究を報告しました。
ホイスラー化合物とは、特定の規則的な結晶構造をもつ金属間化合物の一種です。磁石としての性質や、熱を電気に変換する性質など、多様な特性を示すことから、幅広い分野への応用が期待されています。本研究では、その中でもAB₂C型の組成を持つ「フルホイスラー化合物」を対象としています。
しかし、新しいホイスラー化合物を探索するには、膨大な元素の組み合わせの中から、どの材料が目的の結晶構造を形成するかを見極める必要があります。また、ホイスラー構造にはよく似た結晶構造も存在するため、実験による判別が難しい場合があります。
そこで研究チームが着目したのは、すでに結晶構造が明らかになっている化合物のデータです。既知の化合物に含まれる元素の性質と結晶構造の関係を機械学習で捉えることで、まだ実験で確かめられていない材料についても、ホイスラー構造を形成する可能性を予測しようと考えました。
研究チームは、材料データベースから、AB₂C型の組成をもち、結晶構造が実験的に確認されている1,948種類の化合物データを収集しました。このうち341種類がホイスラー化合物であり、残りは異なる結晶構造を持つ化合物でした。
さらに、各元素の原子半径や価電子数、電気陰性度などに基づく22種類の特徴量を用意しました。特徴量とは、材料が持つ性質や情報を、機械学習で扱える数値として表したものです。
これらのデータを用いてランダムフォレストを学習させることで、元素の性質とホイスラー構造の関係を捉えるモデルを構築しました。このモデルの特徴は、予測対象となる材料の結晶構造をあらかじめ入力することなく、元素の情報からホイスラー構造を形成する可能性を推定できる点です。
3.3 予測結果と実験による検証
構築したランダムフォレストモデルは、ホイスラー化合物の分類において高い性能を示しました。
研究チームは、既知の化合物データを分割して学習と評価を繰り返す「交差検証」によって、モデルの予測性能を評価しました。その結果、実際にホイスラー化合物であるものを正しく判定する割合(真陽性率)は94%、ホイスラー化合物でないものを誤ってホイスラー化合物と判定する割合(偽陽性率)は1%でした。
これは、ホイスラー化合物を見逃しにくく、ホイスラー化合物でないものを候補として選んでしまう割合も低いことを示しています。このような予測性能は、膨大な材料候補の中から実験対象を効率的に絞り込むうえで役立つと考えられます。
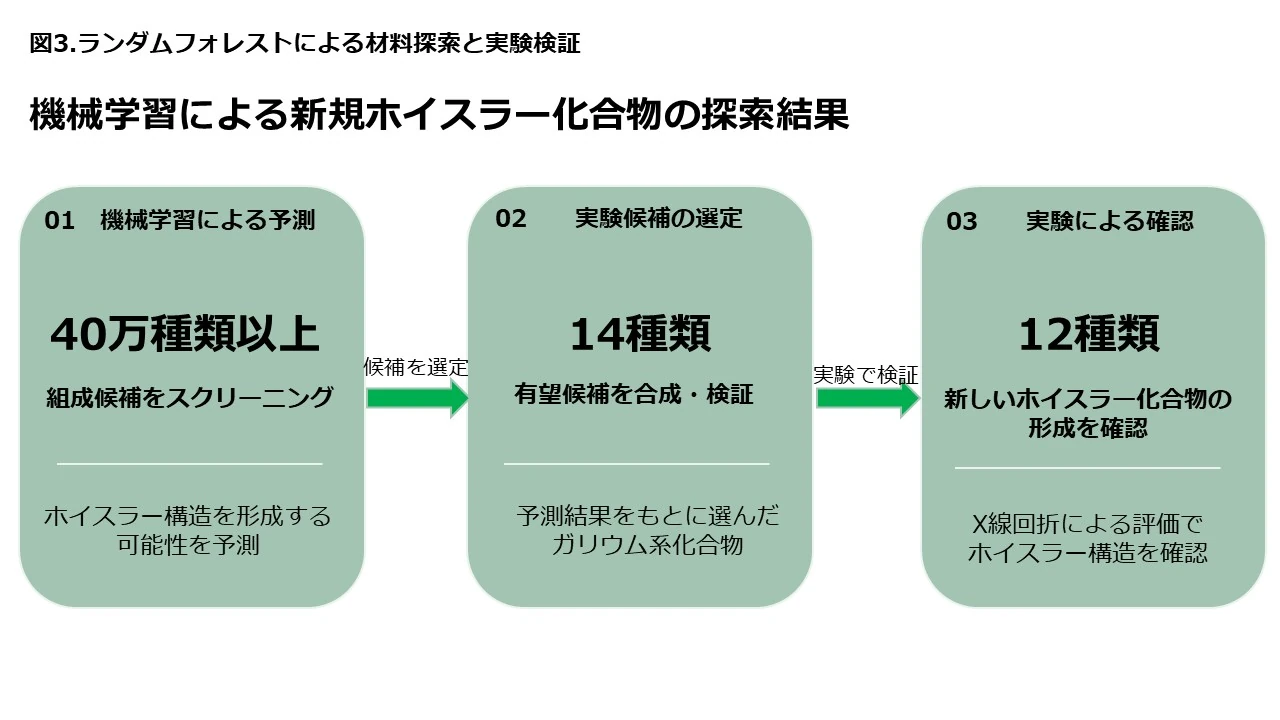
さらに、このモデルを用いて40万種類以上の材料候補を評価しました。これらの予測に要した時間は約45分であり、膨大な候補を短時間で評価できることが示されました。
続いて、研究チームは予測結果をもとに、新しいホイスラー化合物の発見を目指して合成実験を行いました。実験対象には、ホイスラー構造を形成する可能性が高いと予測された14種類のガリウム系化合物を選定しました。
これらの候補について試料を作製し、原子の配列を調べる手法であるX線回折によって結晶構造を評価しました。その結果、14種類の候補のうち12種類で、新しいホイスラー化合物の形成が実験的に確認されました。一方、Niを含む残りの2種類については、今回の実験条件では形成を確認できませんでした。
図3に、機械学習による候補の評価から、実験による新規ホイスラー化合物の形成確認までの流れを示します。
 (拡大画像を開く)
また、研究チームはホイスラー構造を形成する可能性が低いと予測された別の候補についても合成実験を行い、目的の三元化合物が形成されなかったことを報告しています。
この研究の大きな成果は、40万種類以上の候補を短時間で評価しただけでなく、予測をもとに選んだ材料から、実際に12種類の新しいホイスラー化合物の形成を確認したことです。機械学習による予測が、実験を通じた新材料発見に結びついた点に、この研究の意義があります。
ただし、モデルが予測したのは主にホイスラー構造の形成可能性であり、材料の具体的な物性や最適な合成条件を直接予測したわけではありません。また、予測結果が必ず実験で実現するとは限らないため、実験による検証が重要です。
4. まとめ
本記事では、マテリアルズ・インフォマティクス(MI)の基本的な考え方と、ランダムフォレストを用いた新材料探索の応用事例を紹介しました。
Oliynykらの研究では、機械学習によって40万種類以上の候補を評価し、その中から選定した14種類を実験で検証した結果、12種類の新しいホイスラー化合物の形成を確認しました。この研究は、機械学習による予測が、膨大な候補から有望な材料を絞り込み、実際の新材料の発見につなげられる可能性を示しています。
こうしたアプローチを活用することで、研究者は蓄積されたデータをもとに実験の優先順位を判断し、有望な候補から効率的に検証を進められる可能性があります。ただし、予測の信頼性はデータの量や品質によって左右されるため、材料科学の知識に基づく評価や実験による検証が不可欠です。
MIは研究者の知識や実験に取って代わるものではなく、それらを支援する手段です。蓄積されたデータから有望な候補を見つけ、実験で確かめ、その結果を次の探索に活かす。こうした研究の進め方が、新材料の発見をさらに後押しすると期待されます。
IDATENaseでは、材料科学の分野におけるAIの活用にも取り組んでいます。材料開発におけるデータ活用や機械学習の導入・活用についてお困りのことがありましたら、ぜひお気軽にご相談ください。
参考文献
- Oliynyk, A. O., et al. (2016). High-Throughput Machine-Learning-Driven Synthesis of Full-Heusler Compounds. Chemistry of Materials, 28, 7324–7331. https://doi.org/10.1021/acs.chemmater.6b02724