1. はじめに
 (拡大画像を開く)
材料の性質は、どのような元素からできているかだけでなく、内部に形成される微細構造によっても大きく変わることがあります。
例えば、金属やセラミックスでは、異なる物質からなる領域や微小な空隙の分布、大きさなどが、材料の強度や耐久性、電気的な性質に影響を与えます。そのため、材料開発では、こうした微細構造を詳しく調べることが重要です。
では、材料内部に形成される複雑な微細構造をどのように調べればよいのでしょうか。
その代表的な手法の一つが、走査電子顕微鏡(Scanning Electron Microscope:SEM)による観察です。SEMを用いることで、材料の表面や断面に現れた微細な構造を画像として捉えることができます。
しかし、画像の明暗だけで異なる物質の領域を識別するのは容易ではありません。また、各領域の分布や面積割合を定量的に評価するには、多くの時間と労力がかかる場合があります。
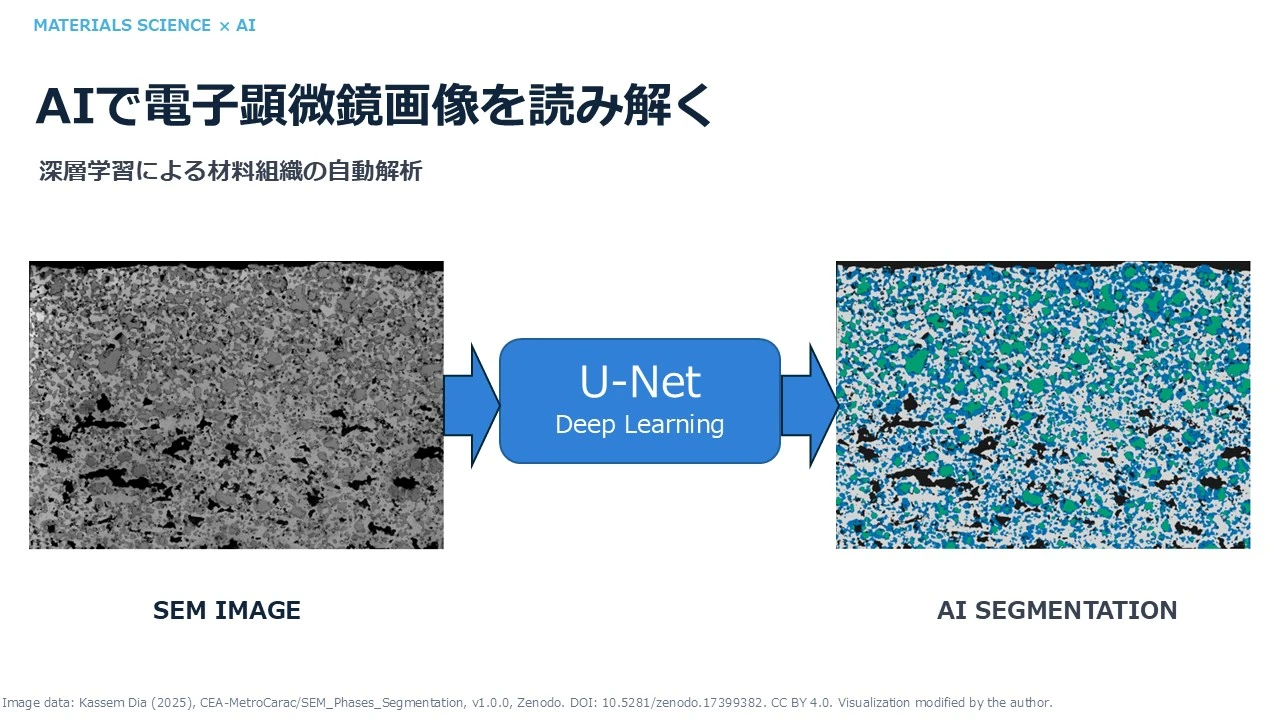
そこで注目されているのが、AI、特に深層学習(ディープラーニング)を用いた画像解析です。AIにSEM画像に現れる模様や境界などの特徴を学習させることで、これまで人の判断に頼っていた領域の識別を自動化し、解析作業を効率化することが期待されています。
Diaら(2025)の研究では、元素分析の情報を学習用ラベルの作成に活用し、学習後はSEM画像のみから材料の各領域を識別できることが示されました[1]。
本記事では、深層学習によるSEM画像解析の仕組みと研究事例を紹介します。さらに、公開された学習済みモデルをPythonで実際に動かし、AIによる材料解析の可能性を探ります。
2. SEMによる材料の微細構造解析
2.1 SEMによる微細構造の観察
SEMでは、細く絞った電子線を試料表面に照射し、そこから発生する電子などを検出することで、画像を生成します。大きな特徴の一つは、一般的な光学顕微鏡よりも、はるかに細かな構造を観察できることです。
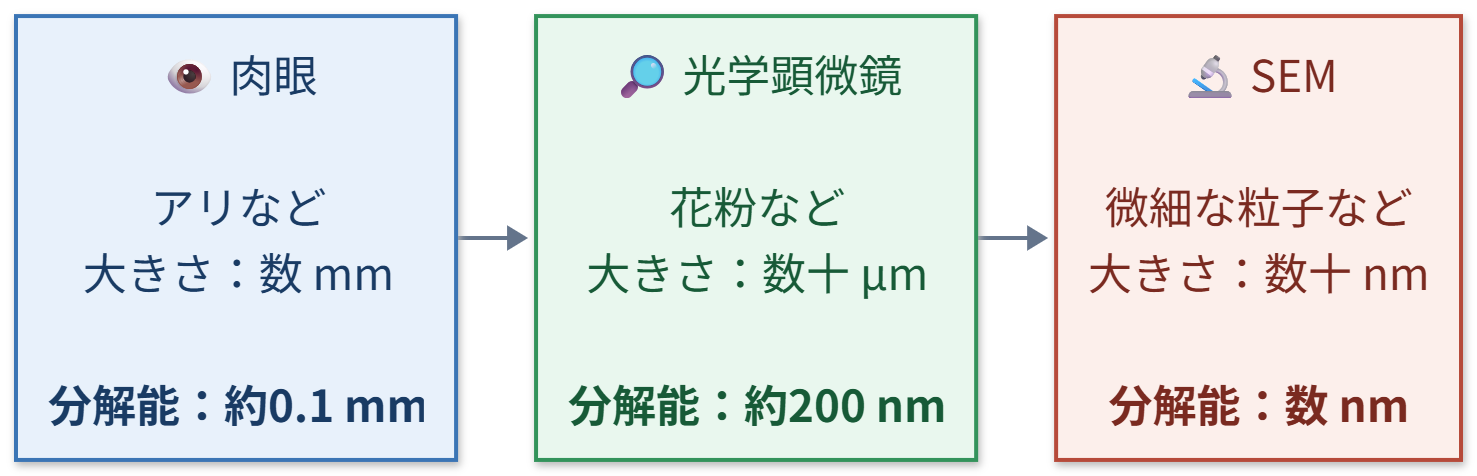
どれほど細かい構造まで見分けられるかを表す指標を「分解能」といいます。一般的な光学顕微鏡の分解能は約200 nm(0.2 μm)ですが、SEMでは装置や測定条件によって、数 nm程度の分解能が得られます。
例えば、人間の髪の毛の太さはおよそ50〜100 μmで、200 nmはその約250〜500分の1に相当します。SEMではさらに細かなナノメートル単位の構造まで観察できます。図1に、肉眼・光学顕微鏡・SEMの分解能と観察対象の大きさの目安を示します。
 (拡大画像を開く)
図1. 肉眼・光学顕微鏡・SEMで観察できる微細構造のスケールの比較(模式図)
しかし、SEMの特徴は、単に微細な構造を観察することだけではありません。検出する電子の種類によって、画像から得られる情報も異なります。
SEMで得られる代表的な画像には、二次電子像と反射電子像があります。二次電子像は試料表面の凹凸を観察するのに適しています。一方、反射電子像では、構成元素の平均原子番号などによって画像の明暗が変化するため、異なる物質からなる領域を見分ける手がかりになります。
2.2 SEM画像解析の課題
前節で紹介した反射電子像では、画像の明暗が異なる物質を見分ける手がかりになります。しかし、それだけで各領域を正確に識別できるのでしょうか。
実際には、異なる物質であっても似た明るさで写ったり、領域同士の境界が不明瞭になったりするため、画像の明暗だけで正確に分類することが難しくなります。
画像中の物質や空隙などを領域ごとに分類する処理を、セグメンテーション(領域分割)と呼びます。従来は、画像の明暗に基準値を設けたり、人が領域を指定したりする方法が用いられてきました。しかし、複雑な微細構造や大量の画像を扱う場合、正確な分類には多くの時間と労力が必要になります。
そこで、SEM画像だけでは判断が難しい場合に活用されるのが、エネルギー分散型X線分析(Energy Dispersive X-ray Spectroscopy:EDS)です。EDSは、電子線の照射によって発生する特性X線から構成元素を調べ、その分布を可視化する手法です。SEM画像では識別しにくい領域を区別する手がかりになりますが、元素分布だけで異なる物質の領域を必ずしも正確に識別できるわけではありません。
また、多数の画像に対してEDSによる元素分布の測定や領域の分類を行う場合、追加の測定や解析作業に時間がかかるという課題もあります。
では、EDSの情報をあらかじめAIの学習に活用し、その後はSEM画像だけで領域を識別できるようになったらどうでしょうか。このような解析を実現する方法の一つが、深層学習を用いた画像の領域分割です。
3. 深層学習によるSEM画像解析
3.1 深層学習による画像の領域分割
深層学習(ディープラーニング)は、ニューラルネットワークを用いて、データに含まれる複雑な特徴や規則性を学習する機械学習の手法の一つです。画像認識や音声認識など、さまざまな分野で活用されています。
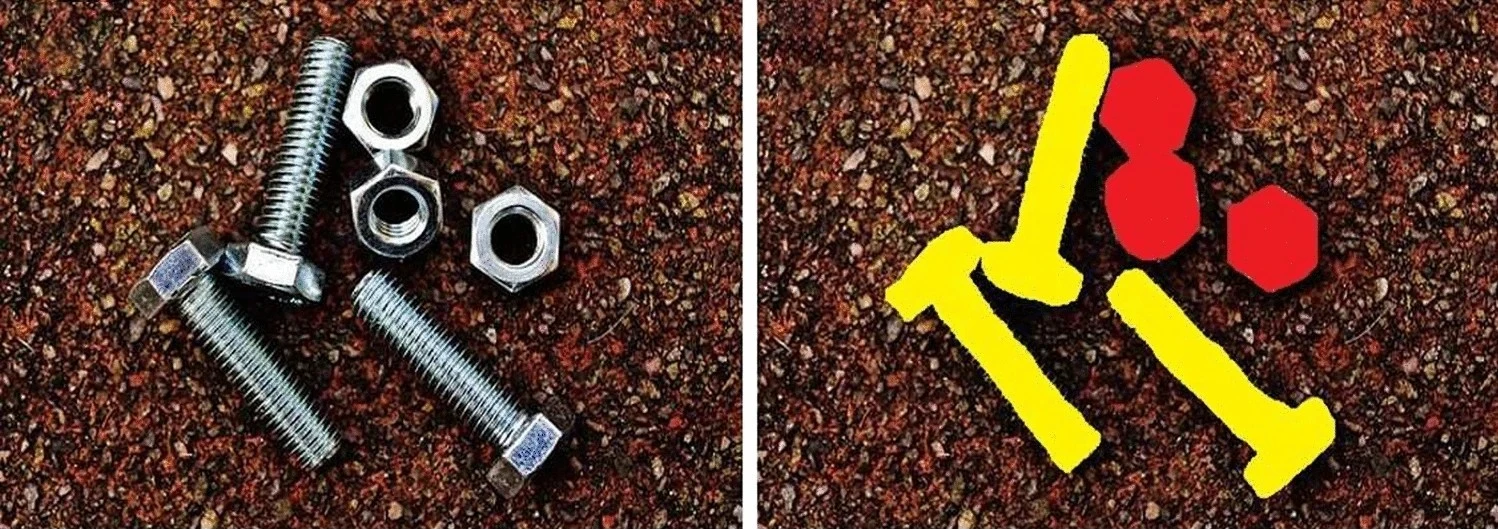
例えば、一般的な画像分類では、画像全体を見て「犬」や「猫」といった種類を予測します。しかし、材料の微細構造を解析する場合には、画像全体を分類するだけでは不十分です。画像のどの部分に、どのような物質や空隙が存在するのかを識別する必要があります。
そこで用いられるのが、セマンティックセグメンテーションです。これは、画像を構成する一つひとつの画素(ピクセル)を、あらかじめ定めた種類(クラス)に分類する手法です。例えば、金属や酸化物、空隙などの領域をそれぞれ異なる色で表示することで、微細構造の分布を視覚的に把握できます。
 (拡大画像を開く)
図2. 画像認識における分類とセグメンテーションの比較
出典:Sharma, R., et al. (2022) [2] . A Survey on Object Instance Segmentation. SN Computer Science, 3, 499, Fig. 1より一部抜粋(トリミング)。CC BY 4.0
AIに各領域の見分け方を教えるには、元の画像と、各画素が属する領域を示した教師ラベル(正解ラベル)を用います。AIは予測と教師ラベルのずれを小さくするように学習し、領域を識別するための特徴を捉えていきます。
学習が完了すれば、新しいSEM画像に対しても、学習した特徴をもとに各領域を自動的に予測できるようになります。ただし、画像から元素組成を直接測定するわけではなく、予測の精度は学習データの品質や撮像条件などによって左右されます。
3.2 U-Netの仕組み
こうした画像の領域分割に用いられる代表的な深層学習モデルの一つが、U-Netです。U-Netは、Ronnebergerら(2015)によって医用画像の領域分割を目的として提案され、現在は材料科学を含むさまざまな分野の画像解析にも応用されています[3]。
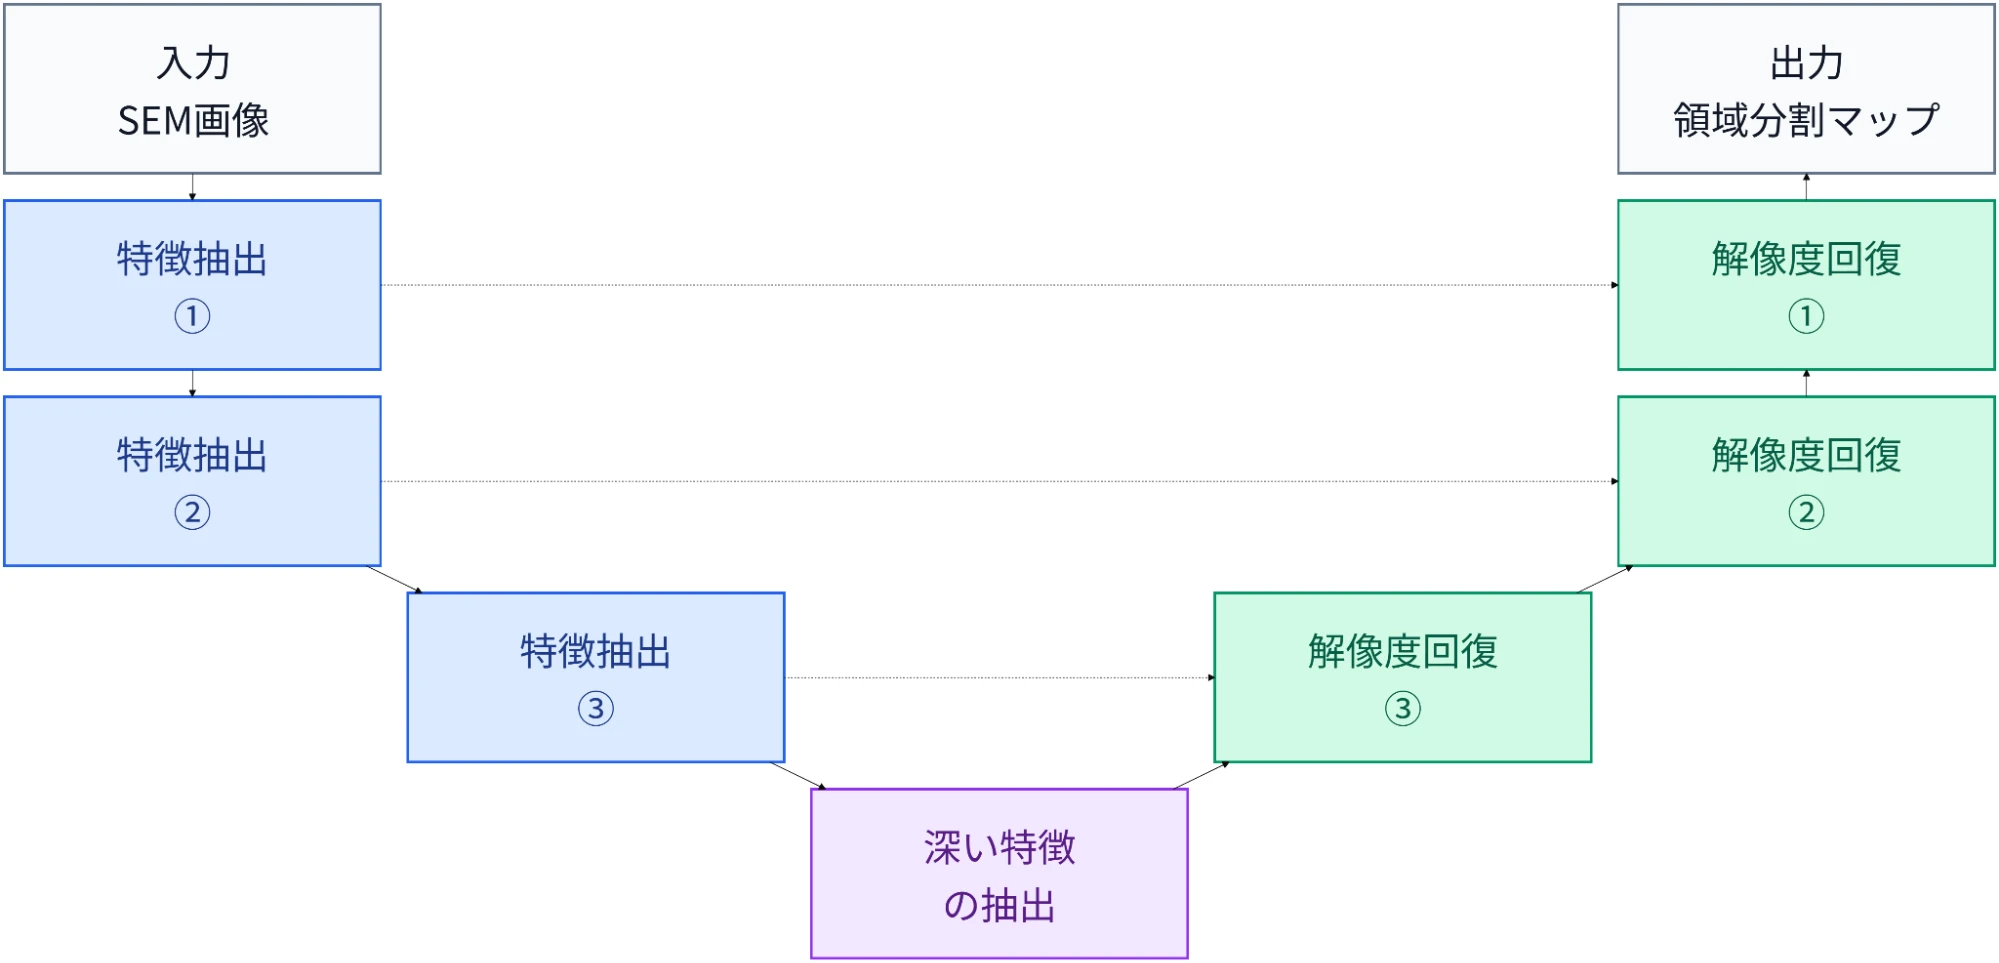
U-Netの特徴は、画像から特徴を抽出する処理と、その特徴をもとに領域の位置や形状を推定する処理を組み合わせていることです。全体の構造がアルファベットの「U」に似ていることから、この名前が付けられました。
 (拡大画像を開く)
図3. U-Netの基本構造(模式図)。特徴抽出と解像度回復の過程を示し、破線はスキップ接続を表す。
まず、入力画像から畳み込み処理によって模様や境界などの特徴を抽出しながら、データの縦横のサイズを段階的に小さくします。これにより、周囲の構造を含めた広い範囲の情報も捉えられるようになります。その後、データのサイズを段階的に戻しながら、各領域の位置や形状を推定します。
ここで重要になるのが、スキップ接続と呼ばれる仕組みです。特徴抽出の途中で得られた情報を復元過程にも直接伝えることで、サイズを小さくする際に失われやすい細かな位置情報を補い、領域の境界を捉えやすくします。
次章では、U-Netを実際の画像に適用したDiaら(2025)の研究事例[1]を紹介します。
4. U-Netを用いたSEM画像解析の研究事例
4.1 研究対象と課題
Diaら(2025)は、固体酸化物セル(Solid Oxide Cell:SOC)の電極材料を対象に、深層学習によるSEM画像の自動解析に取り組みました[1]。
SOCは、高温で動作する電気化学デバイスです。水素などを燃料として電気を生み出すほか、電気を使って水蒸気から水素を製造する用途にも利用されます。この装置の性能や耐久性を左右する要素の一つが電極内部の微細構造です。
今回の研究では、ニッケル(Ni)とイットリア安定化ジルコニア(YSZ)からなる電極材料を対象としました。YSZは、高温で酸素イオンを伝導する性質をもつセラミックスです。電極内部にはNiやYSZに加えて気孔が存在し、Niが酸化すると酸化ニッケル(NiO)が形成されます。
Niの酸化は電極の劣化につながる可能性があるため、Ni・NiO・YSZ・気孔の4種類がどのように分布しているかを調べることが重要です。これにより、酸化に伴う微細構造の変化を定量的に評価できます。しかし、SEM画像では、特にNiとYSZが似た明るさで写る場合があり、画像の明暗だけで4種類の領域を正確に識別することは容易ではありません。
そこで、Diaらは、EDSによる元素分析の情報を活用して教師ラベルを作成し、U-Netに学習させました。学習後はSEM画像だけで4種類の領域を識別できる点が、この研究の核心です。
4.2 U-Netによる領域分割の方法
では、実際にどのようにして、SEM画像だけで材料の各領域を識別できるようにしたのでしょうか。
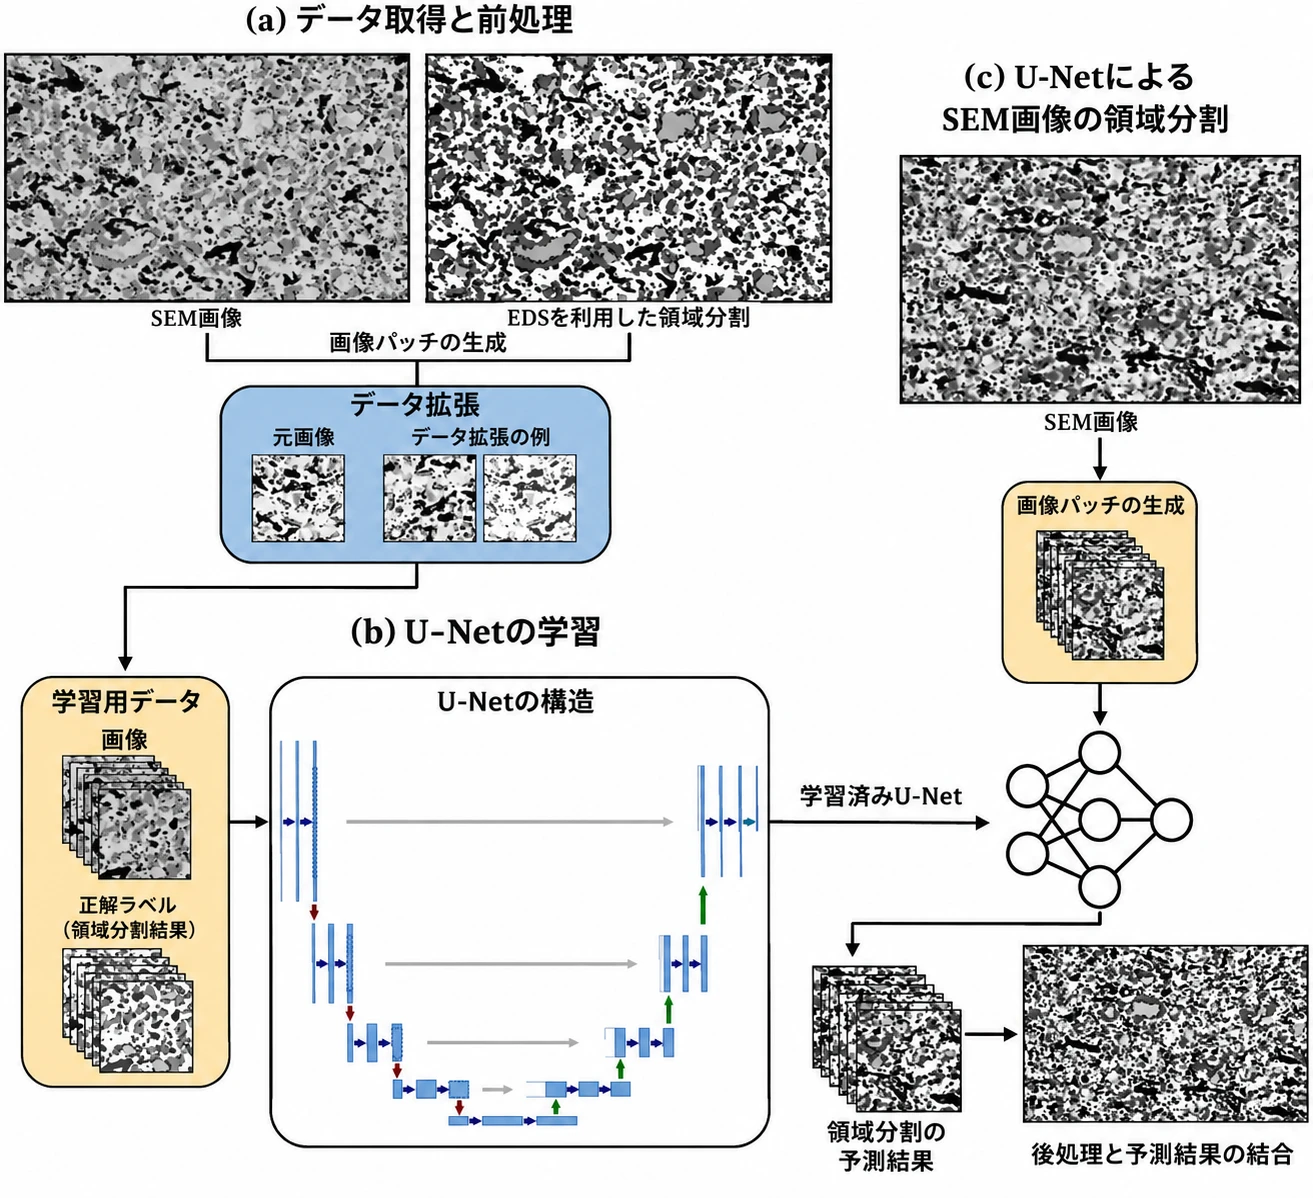
まず、DiaらはSEM画像と対応するEDSの元素マップを組み合わせ、各領域を識別するための教師ラベルを作成しました。この作業には、画像解析ソフトウェアのilastikを使用しました。一部の領域を人が指定し、機械学習手法の一つであるランダムフォレストを用いて画像全体を分類することで、教師ラベルを作成しています。なお、ランダムフォレストの仕組みについては、以前の記事「新材料をAIでみつける — マテリアルズ・インフォマティクスの活用」で紹介しています。
こうして得られた教師ラベルとSEM画像を組み合わせ、U-Netの学習を行いました。
学習に使用した元のSEM画像は、わずか7枚です。そこで、画像を256 × 256ピクセルに分割し、回転や反転、明るさの変更などによるデータ拡張(Data Augmentation)を行い、学習に利用できるデータを増やしました。
この研究の大きな特徴は、学習後の領域分割ではEDS測定を必要としない点です。原著論文の測定条件では、SEM画像の取得に約1.3分、EDSによる元素マッピングには約20分を要していました。学習済みのU-NetはSEM画像のみで領域分割を行えるため、多数の画像を扱う材料研究において、解析工程の大幅な効率化が期待できます。
 (拡大画像を開く)
図4. EDSを用いた教師データの作成からU-NetによるSEM画像の領域分割までの流れ
出典:Dia, K. et al., "Enhanced phase segmentation of scanning electron microscopy images using U-Net with energy dispersive X-ray spectroscopy-guided labelling," Materials & Design, 260, 115200 (2025), Fig. 2を日本語に翻訳・改変。
DOI:https://doi.org/10.1016/j.matdes.2025.115200
© 2025 The Authors. Licensed under CC BY 4.0 (https://creativecommons.org/licenses/by/4.0/).
4.3 PythonによるSEM画像の領域分割
ここまで紹介してきた手法は、実際にどの程度の精度で材料の各領域を識別できるのでしょうか。今回は、DiaらがGitHub上で公開しているPythonコードと学習済みのU-Netモデル[4]を利用し、Google Colaboratory上でSEM画像の領域分割を行いました。
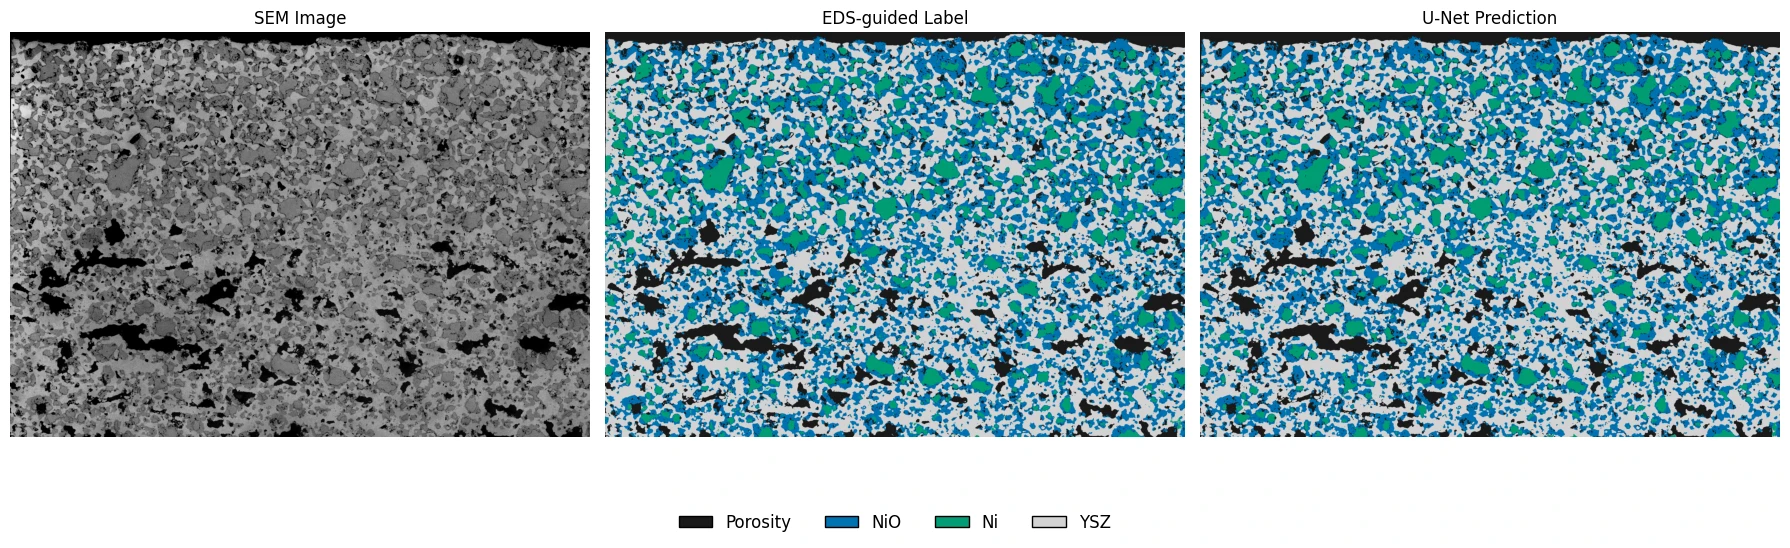
まず、公開されているSEM画像を学習済みモデルに入力し、Ni、NiO、YSZ、気孔の4種類の領域に分類します。その後、AIによる予測結果と、EDSを利用して作成された教師ラベルを比較します。なお、今回はメモリ使用量を抑えるため、画像を小さな領域に分けて解析するSliding Window処理の一部を変更しています。図5にSEM原画像、教師ラベル、U-Netによる予測結果を示します。
 (拡大画像を開く)
図5. SEM原画像(左)、EDSを利用して作成された教師ラベル(中央)、U-Netによる領域分割結果(右)
出典:Dia et al. (2025) の公開データ・学習済みモデルを使用し、筆者が解析・作成。元データ:Kassem Dia (2025), CEA-MetroCarac/SEM_Phases_Segmentation, v1.0.0, Zenodo. https://doi.org/10.5281/zenodo.17399382(CC BY 4.0:https://creativecommons.org/licenses/by/4.0/)。
予測結果を見ると、複雑に入り組んだ微細構造が4種類の領域に色分けされていることがわかります。また、教師ラベルと比較しても、多くの領域でよく一致しています。この一致度を数値で評価したところ、Pixel Accuracy(画素単位の正解率)は95.62%、Mean IoU(各領域の予測と教師ラベルの重なり具合を平均した指標)は90.43%となりました。
つまり、評価対象画像の全画素のうち95.62%で、AIの予測が教師ラベルと一致したことになります。また、Mean IoUの結果からも、4種類の領域の形状や分布を高い一致度で捉えられていることがわかります。原著論文で報告されたPixel Accuracy 95.53%、Mean IoU 91.01%にも近い数値です。ただし、評価対象や推論条件が異なるため、厳密な再現結果ではありません。なお、教師ラベル自体にも誤分類が含まれる可能性があるため、これらの数値が実際の分布に対する完全な正確さを示すわけではありません。
さらに、原著論文では、EDS測定と半手動の領域分割を含む従来の解析工程と比較して、約65〜190倍の高速化が報告されています。これは、従来は数時間を要していた一連の解析工程を、学習済みモデルを利用することで数分程度に短縮できたことを意味します。この結果は、教師ラベルと高い一致度を示す領域分割を行いながら、解析工程を大幅に効率化できる可能性を示しています。
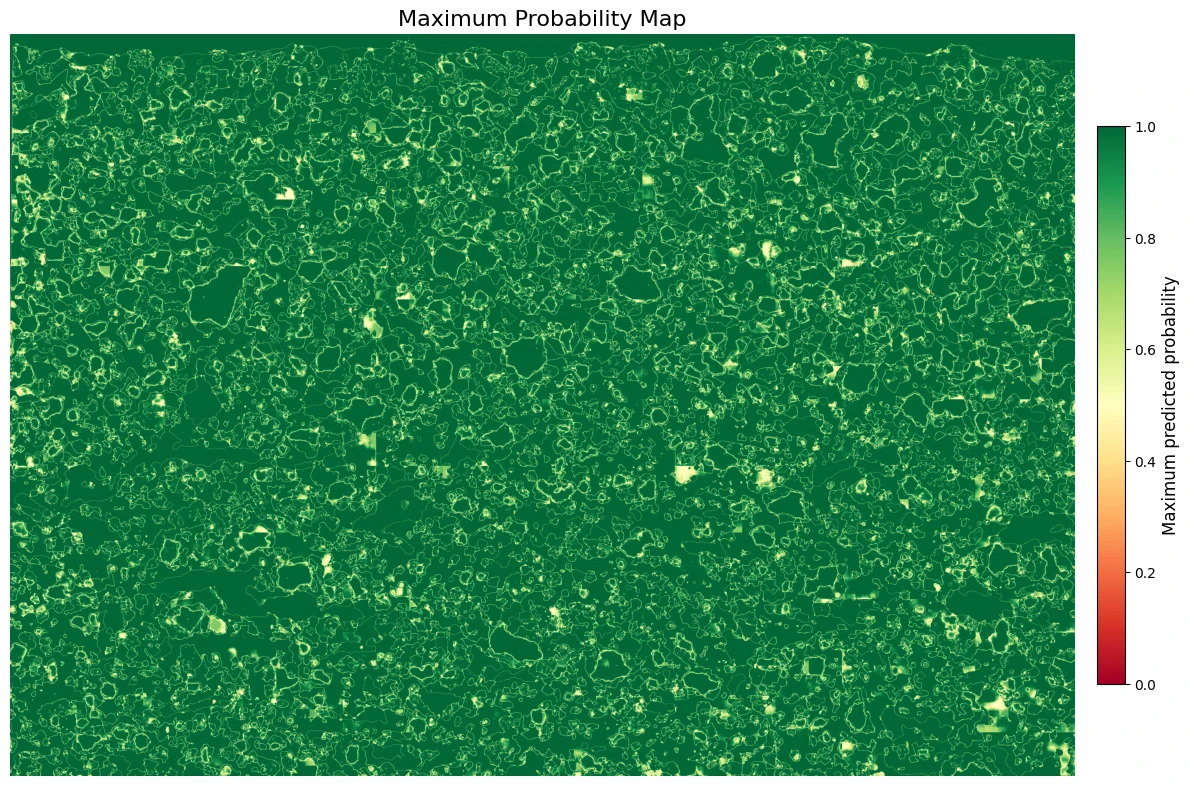
また、AIが各画素をどの程度明確に分類しているのかを確認するため、各画素で最も高いクラスの予測確率を可視化しました。その結果を図6に示します。
 (拡大画像を開く)
図6. U-Netによる最大予測確率マップ。緑色ほど予測確率が高く、黄色や赤色に近づくほど低いことを示す。出典:Dia et al. (2025) の公開SEM画像・学習済みモデルを使用し、筆者が解析・可視化。元データ:Kassem Dia (2025), CEA-MetroCarac/SEM_Phases_Segmentation, v1.0.0, Zenodo. https://doi.org/10.5281/zenodo.17399382(CC BY 4.0:https://creativecommons.org/licenses/by/4.0/)。
図6を見ると、各領域の内部では予測確率が高い一方、領域の境界付近では低くなる傾向が見られます。これは、異なる領域が接する部分では、AIが分類を判断しにくくなっている可能性を示しています。ただし、予測確率が高いからといって、必ずしも分類が正しいとは限りません。この図は、AIの予測の傾向を理解するための手がかりとなります。
5. まとめ
本記事では、深層学習を用いたSEM画像解析について、基本的な仕組みから実際の研究事例までを紹介しました。Diaら(2025)の研究では、EDSによる元素分布の情報を活用してU-Netを学習させることで、学習後はSEM画像のみから4種類の材料領域を自動的に識別する手法が示されました。さらに、公開された学習済みモデルをPythonで実際に動かしたところ、教師ラベルと高い一致度を示す領域分割結果が得られました。
一方で、AIによる予測には限界もあります。解析精度は学習データの品質や撮像条件によって左右されるため、予測結果を適切に評価することが欠かせません。
それでも、従来は追加の測定や手作業に多くの時間を要していた画像解析をAIによって効率化できれば、研究者はより多くの画像を解析し、材料の微細構造を詳しく調べられるようになります。AIは、材料の微細構造をより効率的に、そして定量的に読み解くための有力な手段となりつつあります。
IDATENaseでは、材料科学の分野におけるAIの活用にも取り組んでいます。材料開発におけるデータ活用や機械学習の導入・活用についてお困りのことがありましたら、ぜひお気軽にご相談ください。
参考文献
[1] Dia, K. ほか, "Enhanced phase segmentation of scanning electron microscopy images using U-Net with energy dispersive X-ray spectroscopy-guided labelling", Materials & Design, 260, 115200, 2025年. https://doi.org/10.1016/j.matdes.2025.115200
[2] Sharma, R. ほか, "A Survey on Object Instance Segmentation", SN Computer Science, 3, 499, 2022年. https://doi.org/10.1007/s42979-022-01407-3
[3] Ronneberger, O. ほか, "U-Net: Convolutional Networks for Biomedical Image Segmentation", Medical Image Computing and Computer-Assisted Intervention – MICCAI 2015, 2015年. https://doi.org/10.1007/978-3-319-24574-4_28
[4] CEA-MetroCarac, "SEM_Phases_Segmentation(GitHub)". https://github.com/CEA-MetroCarac/SEM_Phases_Segmentation (閲覧日:2026年11月13日) Diaら(2025)の研究で使用されたPythonコード・学習済みモデル・サンプルデータを公開。保存版はZenodoで公開。
図4〜図6およびサムネイル画像には、Diaら(2025)の論文・公開データを使用しています。図4は原著論文のFig. 2を日本語に翻訳・改変したものです。図5・図6およびサムネイル画像は、公開データをもとに筆者が解析・編集したものです。いずれもCC BY 4.0ライセンスに基づいて使用しています。各図の出典およびライセンス情報は図の下と参考文献[1][4]に記載しています。