1. はじめに
近年のAIブームに伴い、「生成AI」の利用は日常の一部になりました。
普段の生活から、ChatGPTをはじめとした「生成モデル」を使用することは当たり前になりつつあります。生成AIは、テキストに加えて画像や音声、動画なども生成できるようになり、生成できるコンテンツの種類が広がるとともに、その品質も向上しています。
私たちは日常的にAIを利用するうえで主に表面のみを見ることが多いと思いますが、その中でこういった疑問が生じるのではないでしょうか?
AIは画像といった視覚的データをどこで生成するのか?
あるいは
AIはどうやって何かを想像できるのか?
生成AIを用いて画像を作成したり、画像を読み取ったりすることは当たり前になりつつありますが、その詳しい仕組みに関しては知らないまま利用している方も多いと思います。
ここでカギになるのは「潜在空間」という概念です。
この潜在空間とは、元のデータが持つ特徴を、モデル内部で扱いやすい少数の数値にまとめて配置した空間のことを指します。例えば画像であれば、「形」「向き」といった情報が、そのまま言葉としてではなく、数値の組み合わせとして表現されます。いわば、画像の情報を座標に置き換え、それをもとに地図を作るイメージです。
生成モデルの中には、元のデータを直接扱うのではなく、一度潜在空間に写してから生成処理を行うものもあります。人間の直感からすれば、わざわざ別の空間へ写す必要がないようにも思えます。では、なぜ生成モデルは元のデータではなく、一度別の空間に写すのでしょうか?
実務においても、単に既存のモデルを課題に適用するだけでなく、AIにどの情報を、どのような形で見せるかという「表現の設計」が重要になります。弊社でも、日々の開発の中でこうした点を意識しながら、モデルやデータの設計を行っています。
こうしたモデル内部の仕組みを理解することは、ブラックボックスに見えがちなAIを理解する第一歩にもつながります。
それでは、生成処理に関するこの疑問に対して、AEやVAEを用いて考えてみましょう。
2. AEとVAEとは?
そもそもAEとVAEとは一体何なのでしょうか?
Autoencoder(AE)は、入力データを一度低次元の表現に圧縮し、そこから元のデータを復元するニューラルネットワークです。
例えば画像であれば、28×28ピクセルの画像を少数の数値にまとめ、その数値から再び元の画像に近いものを復元します。
AEは主に、入力を低次元の潜在表現に変換するEncoderと、その潜在表現から元のデータを復元するDecoderから構成されます。
AEは、元の情報をできるだけ失わずに小さな表現へ圧縮することを目指します。一方で、潜在空間のどこから点を取れば意味のある新しいデータを生成できるかまでは、通常のAEではあらかじめ定められていません。
 (拡大画像を開く)
Variational Autoencoder(VAE)は、AEの考え方を生成に利用しやすい形へ拡張したモデルです。
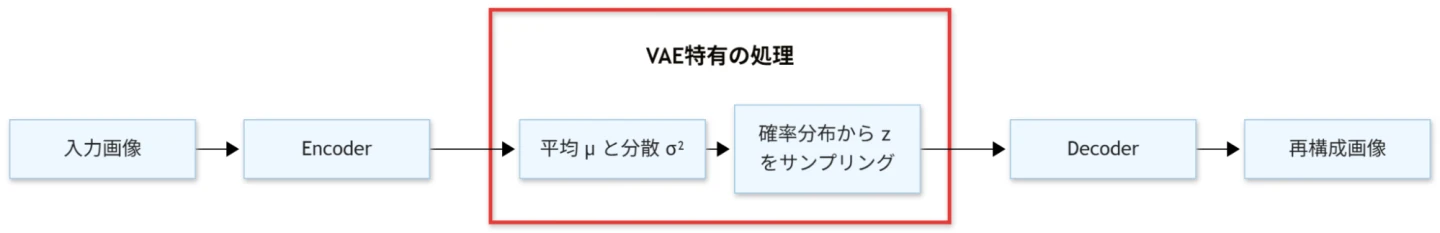
AEが各入力を潜在空間上の1点に変換するのに対し、VAEでは各入力に対して、平均と分散を持つ確率分布を考えます。
この分布から潜在変数をサンプリングし、Decoderからデータを復元します。
その結果、VAEでは単にデータを圧縮するだけでなく、標準正規分布からサンプリングして新しいデータを生成しやすい潜在空間を作ることを目指します。
標準正規分布とは、平均が0、分散が1の正規分布です。値は0付近に集まりやすく、0から離れるほど現れにくくなります。例えるなら、中心に人が多く集まり、外側に行くほど人が少なくなるような分布です。
 (拡大画像を開く)
データを小さく圧縮するだけならば、AEでも実現できます。一方、VAEでは、潜在表現がこの標準正規分布から大きく外れないように学習することで、潜在空間のどこから点を選べばよいかという基準を持たせます。これが、単にデータを圧縮・復元するAEとの大きな違いの一つです。
例えるなら、潜在空間の中で「このあたりから点を選べばよい」という目安を、あらかじめ作っておくイメージです。
ここまでで、AEやVAEがデータを圧縮し、潜在表現を使って復元・生成する仕組みを大まかにつかめたと思います。では、実際には「うまく圧縮できる表現」と「うまく生成できる表現」は、何が違うのでしょうか?
今回は、こういった疑問を出発点に、Google ColabのNotebookを動かしつつ実際にAEとVAEを学習させてみることで潜在空間を目に見える形で観察してみます。小規模な実験から、「生成に適した表現空間とは何か」を考えてみましょう。
3. 実験環境
今回は主にGoogle ColabとPyTorchを使用します。データセットには、Fashion-MNISTを採用しました。Fashion-MNISTとは、28×28ピクセルのグレースケール画像からなる比較的小規模なデータセットで、Tシャツやブーツなど10種類の衣類のカテゴリが含まれています。このデータセットは、AEやVAEを短時間で学習できることに加え、見た目の特徴が近いカテゴリが含まれているため、潜在空間上で分布の観察が容易です。そのため、今回は潜在空間上で「似たもの」がどのように配置されるのかを見るには最適のデータセットであると考え、こちらを採用します。
なお、今回は潜在空間を目で見てみることを優先とするため、AE・VAEともに潜在空間は2次元で可視化します。潜在空間を2次元に限定することにより、1枚の画像を平面上の1点として可視化します。つまり、画像同士の「似ている/異なる」といった関係を、地図を見るかのように観察することができます。
4. AEとVAEの再構成結果を比較する
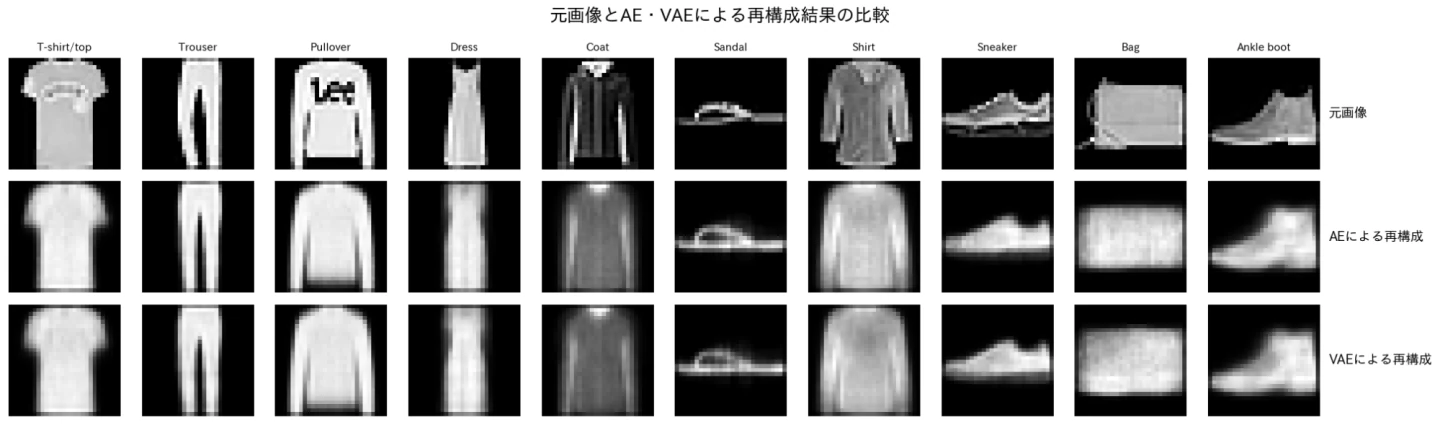
本格的にAEの潜在空間を見る前に、まずAEとVAEがどの程度元画像を再構成できるか確認します。潜在表現を扱う上で重要なのはどれだけ元のデータを保持できるかです。ここでは「元のデータの情報をどれだけ保持できているか」を確認していきます。
 (拡大画像を開く)
元の画像は28×28のピクセル画像でした。それが、わずか2次元にまで圧縮しても、大まかな形状情報は残っていることが上記の比較から視覚的に確認できます。もちろん、2次元に圧縮しているため、元画像に含まれるような細かい模様などといった情報は失われてしまっています。一方で、各衣類を特徴づける大まかな形状はAE・VAEともに維持されています。
5. AEで潜在空間を見てみる
最初に比較対象としてシンプルなAEを作ります。28×28ピクセル(784次元)の画像を、今回は強引に「2次元」に圧縮し、そこから再び784次元へ復元するネットワークを構築しました。
5.1 AEが作る潜在空間を見てみる
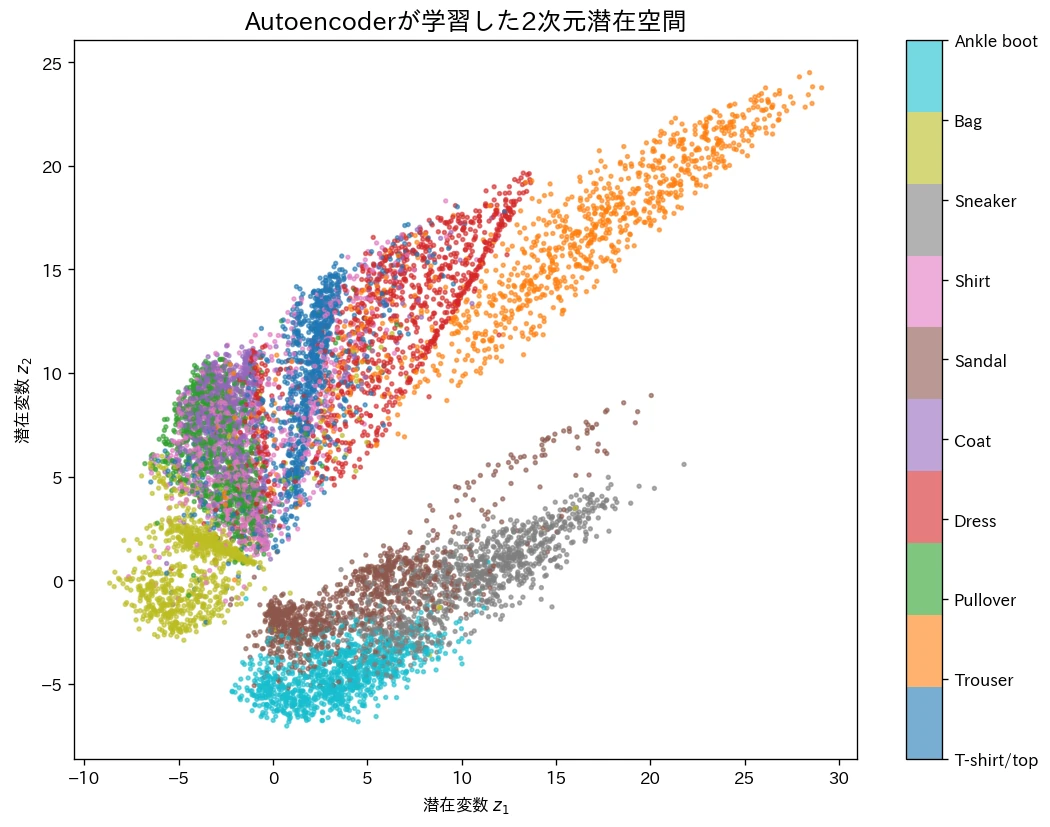
ここではAEに注目し、AEが作成した「潜在表現そのもの」を見てみます。データをEncoderに通して得られた値を2次元平面上にプロットし、カテゴリ毎に色分けしてみます。
 (拡大画像を開く)
上の図では、衣類の種類毎に色分けされています。この図を見てみると、AEは衣類をランダムに圧縮しているのではなく、衣類のカテゴリに応じた構造を自発的に形成していることが分かります。実際、履物類や衣類は異なった領域に出力されているのが視覚的に理解できると思います。
それらに加えて
- T-shirt / Pullover / Shirt / Coatなどはかなり重なる
- Sneaker / Sandal / Ankle bootは別の領域を形成
- 潜在空間内に、使用していない領域が明確にある
- 細長い枝やクラスタのような形を作っている
といった特徴がくっきりと分かると思います。
このマッピングされた座標から、画像が再生成されていきます。
では、この空間の場所から、本当に画像を再生成できるのでしょうか?
5.2 潜在空間からランダムに生成できるか?
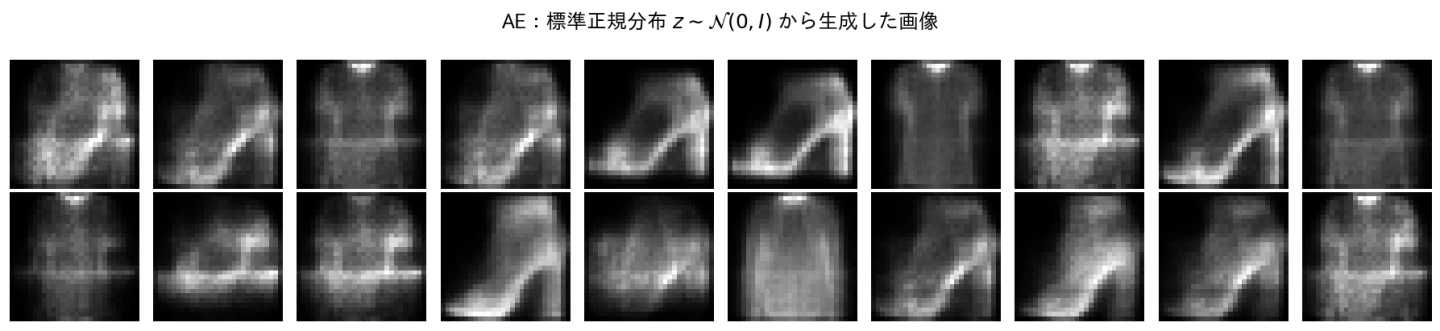
AEでは、生成時に潜在空間のどこから点を選ぶべきかという分布は学習されていません。そこで今回は、標準正規分布からランダムに潜在点を取得し、Decoderへ入力してみます。
 (拡大画像を開く)
AEではサンプリング分布が定められていないため、意味のある画像が得られるかは保証されません。サンプリング分布とは、潜在空間のどのあたりから点を選ぶか決める確率分布です。実際には、鞄や衣類らしい特徴を持つ画像も生成されました。ただし、この出力結果には偏りが見られました。AEの潜在空間を見ることで、その理由が明らかになってきます。
AEが学習した潜在表現は広い範囲に分布しているのに対し、標準正規分布からのサンプルは主に原点付近に集中します。そのため、今回の方法ではAEの潜在空間のごく一部しか探索できていません。
つまり、AEでもDecoderから新しい画像を生成すること自体はできます。しかし、「潜在空間のどこからサンプリングすればよいか」はAEの学習目的には含まれていません。
これらの結果から「データを圧縮できることと、その空間から新しいデータを生成できることは別の問題ではないか?」という点が見えてきます。
6. VAEでは何が変わるのか?
AEで見えたこの問題を考えるために、次にVAEを試してみます。AEはデータの空間の「1点」に変換するのに対して、VAEは各入力に対して「平均」と「分散」を持つ確率分布を考えます。
また、VAEの学習時には「元の画像を復元したい」という要求に加えて、「潜在表現がバラバラな場所へ飛び散らないようにしたい」という制約を与え、各入力に対応する潜在分布が、事前分布である標準正規分布から大きく外れないように正則化します。
6.1 AEとVAEの違いを検討する
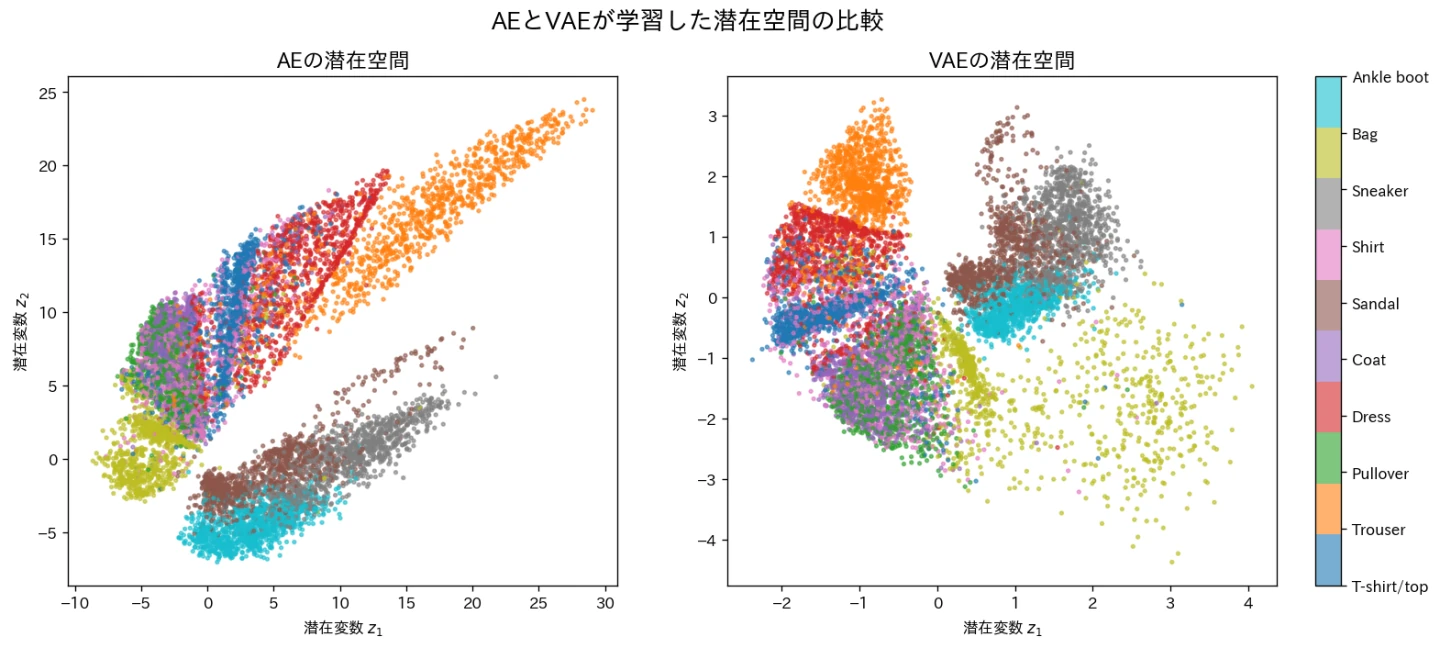
VAEに関してもAEと同様の可視化を行います。
この比較はAEとVAEの「生成性能を公平に競わせる」ものではなく、VAEでは事前分布からのサンプリングがモデル設計に組み込まれている点を見るための実験です。
 (拡大画像を開く)
上の図を比較してみましょう。AEでは各データが広い範囲へ伸びているのに対し、VAEではより限定された範囲にまとまって配置されていることが視覚的にも分かります。
一方、VAEだからといってクラスがきれいに分離されるわけではありません。衣類カテゴリには大きな重なりもあります。つまり、「生成に利用しやすい潜在空間を作ること」と「クラスを分類しやすくすること」は別の問題です。
 (拡大画像を開く)
 (拡大画像を開く)
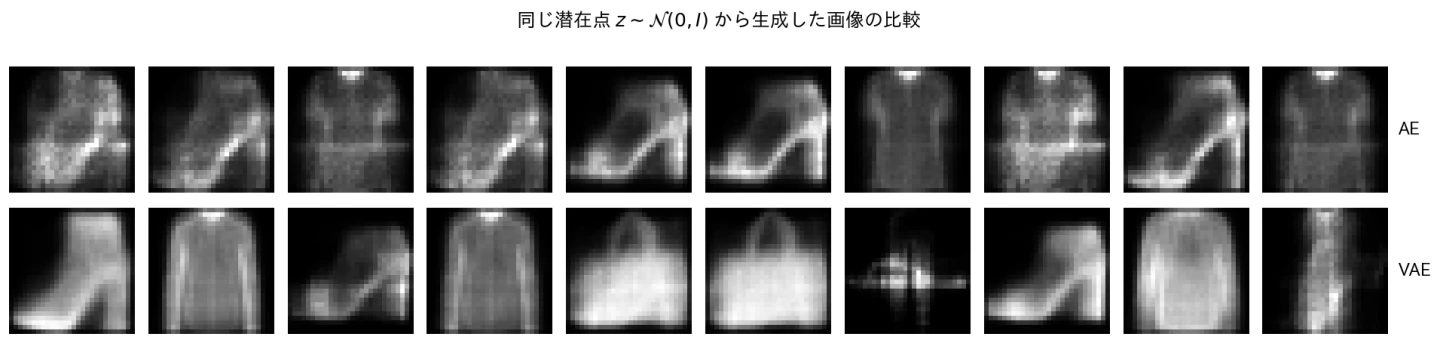
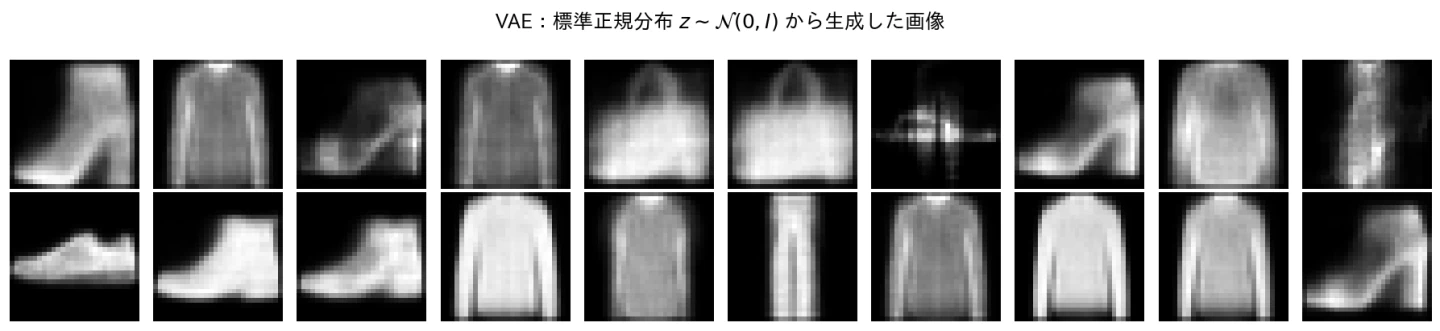
ここで、同じ標準正規分布から得た潜在点をAEとVAEそれぞれのDecoderへ入力してみます。その結果、生成された画像には大きな違いが見られます。
AEでも衣類らしい画像は生成されますが、出力される衣類の種類にはかなり偏りがあります。一方、今回のサンプルでは、VAEの方がAEよりも複数の形状を含む生成結果となりました。
重要なのは、単純に「VAEの方がきれい」ということではありません。ここで重要なのは、それぞれの潜在空間が何を得る代わりに、何を失っているのかというトレードオフを見ることです。VAEでは学習時から事前分布を想定しているため、そこからサンプリングすること自体に意味があります。
ここからVAEでは潜在空間を作るだけではなく、「どの分布から点を取れば新しいデータを生成できるのか」まで含めて設計されている点がAEとの大きな違いの一つだと考えられます。
6.2 潜在空間上で補間してみる
 (拡大画像を開く)
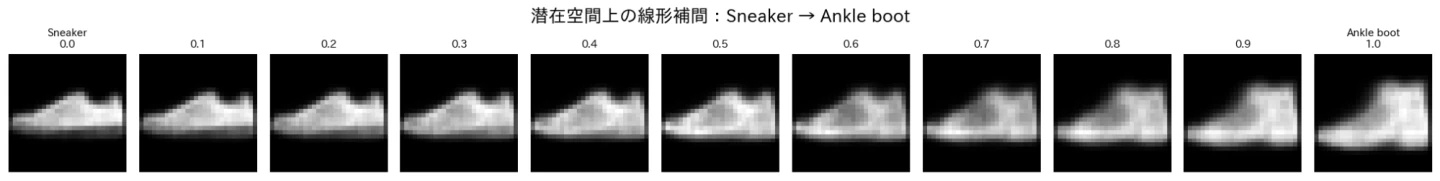
ではここで、表現の間を補間してみることで、画像がどのように変化するのかを見てみましょう。イメージとしては、地図上の2地点の間を直線的に移動してみるようなものです。SneakerとAnkle bootの潜在表現の間を直線的に補間すると、生成画像も段階的に変化しました。特に、補間係数を増やすにつれて足首部分が徐々に高くなり、SneakerからAnkle bootへ連続的に形状が変化していることが分かります。
少なくとも今回選んだ2点の間では、潜在空間上の連続的な移動が、出力画像の連続的な変化に対応しています。
6.3 潜在表現の局所的な変化は出力にどう影響するか?
 (拡大画像を開く)
 (拡大画像を開く)
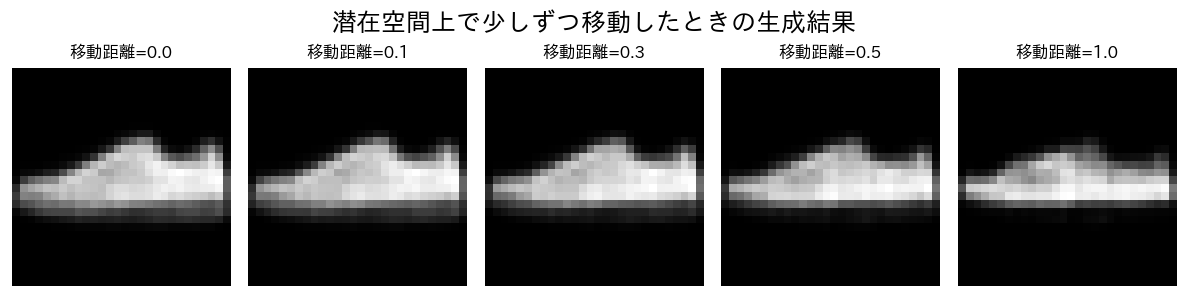
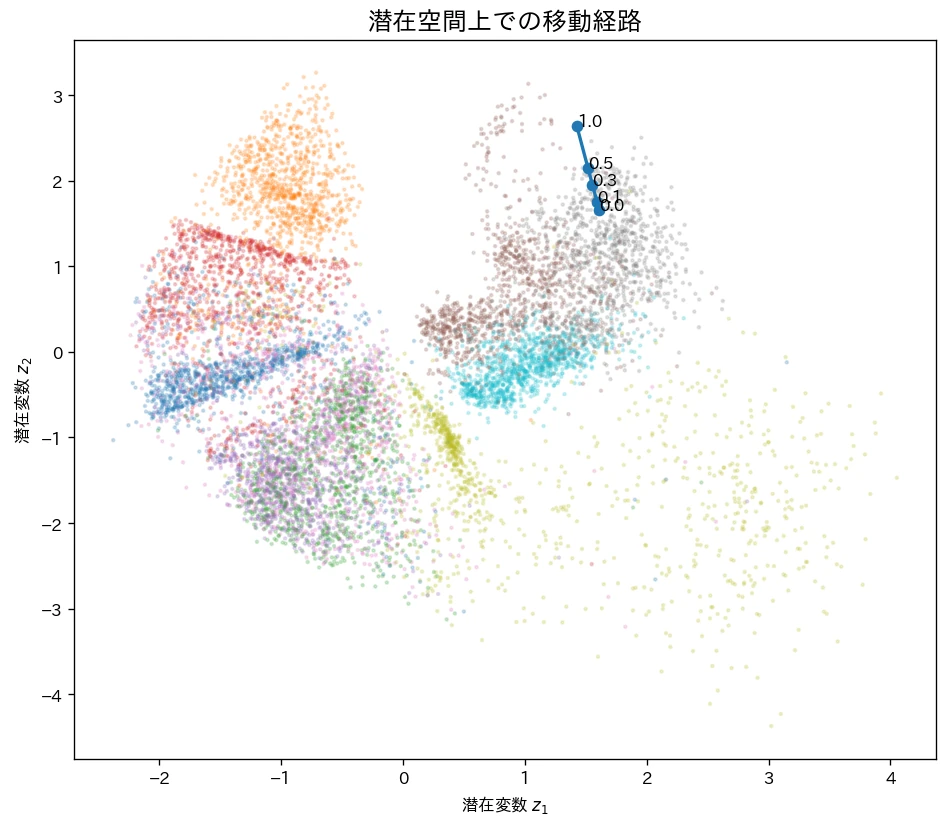
次に、1つのSneakerの潜在表現から同じ方向へ少しずつ移動させてみましょう。移動距離が小さい間では元画像とほぼ同じ形状が維持され、距離を大きくすると輪郭が徐々に変化していきます。
今回選んだ点と方向に限れば、潜在空間上の小さな変化は、画像上でも小さな変化として現れました。少なくとも局所的には、潜在空間上の「近さ」にある程度意味があることが確認できます。
7. 実験から「生成に適した表現」を考える
本記事での実験では「良い潜在空間」を厳密に定義したわけではありません。ただ、AEとVAEの潜在空間をシンプルなデータセットを用いた実験を通して実際に触れてみることにより、本記事では「生成に適した表現」を見るための観点を、以下の4つにまとめました。
- Reconstructability(再構成能力):元のデータに必要な情報を保持し、復元できるか。
- Sampleability(サンプリング能力):学習データそのものではない潜在点からも、意味のある出力を生成できるか。
- Navigability(探索可能性):潜在空間上を連続的に移動したとき、出力も自然に変化するか。
- Local consistency(局所的整合性):潜在空間上で近い点が、出力上でも近い結果になるか。
これらは、既存研究における正式な分類ではなく、今回の実験結果を整理するために本記事内で設定した観点です。少なくとも、本実験の結果を通して「元のデータをうまく圧縮できること」だけでは、生成に使いやすい表現になっているとは限らないということは、直感的に理解いただけたのではないでしょうか。
8. 実際のAI開発における表現設計
ここまでの実験では、同じ画像であっても、AIの内部でどのように表現するかによって、生成される画像や潜在空間の性質が変わることを見てきました。
この考え方は、画像だけに限ったものではありません。実際のAI開発では、現実世界のデータを「AIにどのような形で見せるか」を考えることが重要です。
例えば、画像であればそのままピクセルとして扱う方法もあれば、今回のように特徴をまとめた潜在表現として扱う方法もあります。センサから得られるデータであれば、時間とともに変化する数値として扱ったり、その特徴を別の形に変換して扱ったりします。分子や3Dデータについても同様に、AIが扱いやすい形へ表現する方法が複数存在します。
つまり、AI開発では単に「どのAIモデルを使うか」を決めればよいわけではありません。
課題 → データ → AIにどう見せるか → モデル → 評価
という一連の流れを考える必要があります。
今回のAEやVAEの実験でも、同じFashion-MNISTの画像を扱っているにもかかわらず、AEとVAEとの間でも、画像を生成したときの結果に違いが現れました。これは、データをどのように表現するかが、AIの振る舞いにも影響する一例と考えることができます。
実際のAI開発でも、既存のAIモデルをそのまま当てはめるだけではなく、解決したい課題や扱うデータの特徴に応じて、「AIにどの情報を、どのような形で見せるか」という段階から、モデル構成や評価方法まで含めて検討し、目的に沿ったAI開発につなげることが非常に重要です。弊社においても、こういった点を意識して開発を行っています。
9. まとめ
今回はFashion-MNISTを用いてAEとVAEを実際に学習し、潜在空間を「再構成」「ランダムサンプリング」「補間」「近傍への摂動」という観点から観察してみました。
元のデータを別の表現に写すことは、単にデータ量を小さくするためだけではありません。生成モデルにとっては、その空間が、
- どのデータを近くに配置するか
- どの場所からサンプリングできるのか
- 空間表現の移動にどのような意味を持たせるのか
に関わります。普段何気なく使っている生成モデルに関しても、「どんなモデルを使っているか」に加えて、「何を、どのような空間で表現しているのか」にも着目すると、モデルの設計意図も少し違ってみえてくるはずです。